Compétences visées
- Dialoguer avec un LLM et écrire un prompt utile
- Faire dire une erreur à une IA et la prouver avec une source
- Comprendre l'infrastructure du numérique (puces, réseaux, sites web)
- Saisir la notion de trace numérique et son lien avec le marketing
L'essor du numérique
Internet et le Minitel
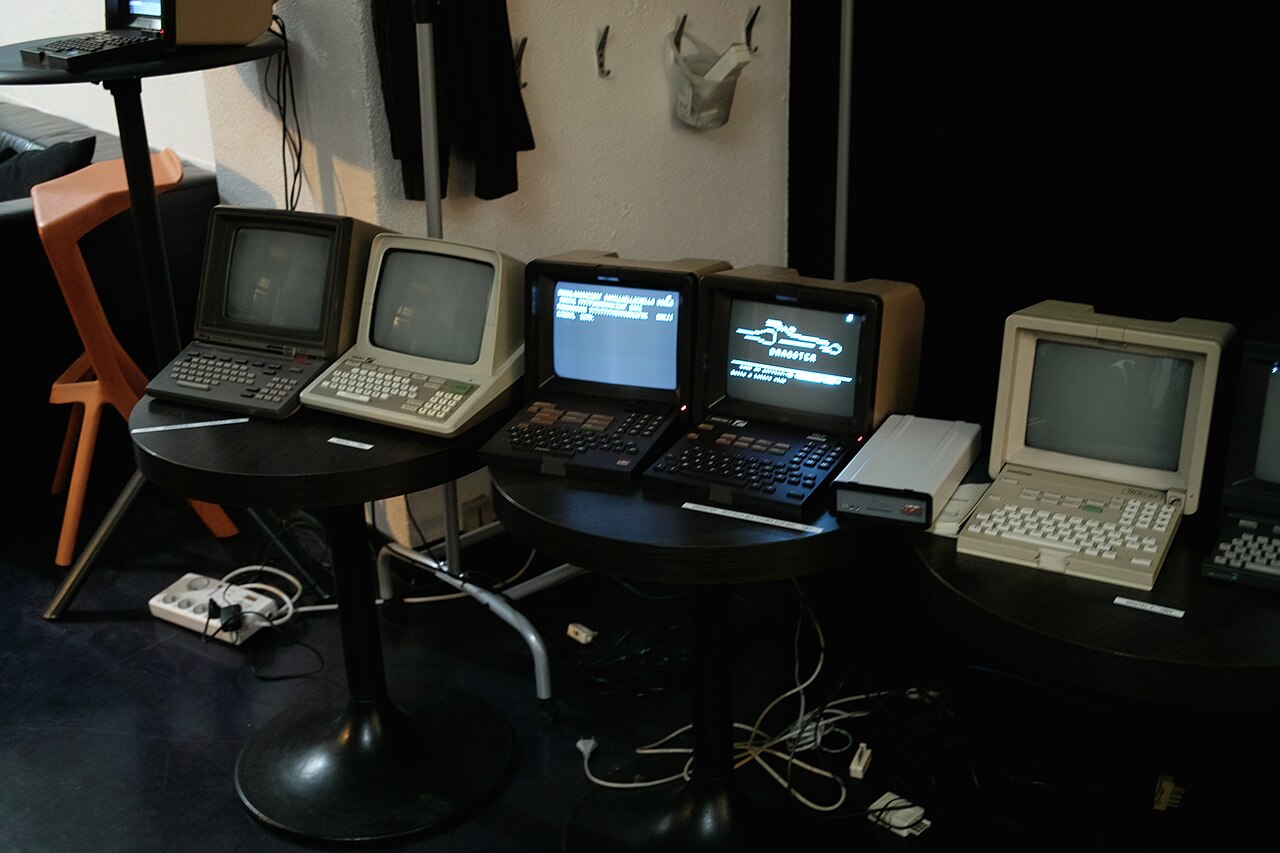

Avant internet, la France a eu son propre réseau grand public : le Minitel, expérimenté à Saint-Malo et à Vélizy dès 1980, puis déployé dans tout le pays à partir de 1982.
Le terminal de base était distribué gratuitement par les PTT, avec l'idée de remplacer l'annuaire papier, ce qui explique une diffusion très rapide : 1,4 million de terminaux début 1986, 6,5 millions de foyers équipés au pic de 1993.
On y consultait l'annuaire, la météo ou ses comptes bancaires, on y réservait un billet de train et on y achetait par correspondance, en payant à la minute sur sa facture de téléphone.
Les entreprises ont découvert avec le 3615 un modèle économique nouveau : un service à distance, facturé à l'usage, sans magasin ni vendeur, qui générait encore près d'un milliard d'équivalents euros de revenus en 1995.
Pendant ce temps, internet naissait aux États-Unis : le réseau ARPANET en 1969, puis le Web, inventé au CERN par Tim Berners-Lee entre 1989 et 1991 (voir l'histoire d'Internet).
Le Web ne s'ouvre au grand public qu'au milieu des années 1990, avec les premiers navigateurs et les premiers fournisseurs d'accès.
La France, équipée d'un Minitel qui marchait, a pris du retard : en 1998, 6 % des Français utilisaient internet selon la Banque mondiale, alors que le Minitel comptait encore près de 25 millions d'utilisateurs en 2000.
Le Minitel n'a été éteint que le 30 juin 2012, trente ans après son lancement, et 2 millions de personnes l'utilisaient encore en 2010.
Retenez le mécanisme, il reviendra à chaque titre de ce chapitre : une technologie installée et rentable freine l'adoption de la suivante, même quand celle-ci est bien meilleure.
Le chapitre « Comment marche un site web » expliquera comment internet transporte les pages ; ici, ce qui nous intéresse, c'est la vitesse à laquelle les gens et les entreprises s'en emparent.
L'adoption par les entreprises
La courbe ci-dessus donne la mesure du phénomène : 1,6 % des Français utilisaient internet en 1995, 14 % en 2000, 43 % en 2005, 77 % en 2010 et 89 % en 2024.
En quinze ans, un marché de niche est devenu le marché de tout le monde, et les entreprises ont dû suivre leurs clients.
L'INSEE mesure cette adoption depuis 2003 dans son enquête sur les technologies de l'information dans les sociétés de 10 salariés ou plus.
En 2003, 77 % des sociétés de 10 à 19 salariés étaient connectées à internet ; en janvier 2009, elles étaient 94 %, et 100 % des sociétés de 250 salariés ou plus (Insee Première n° 1323, 2010).
Être connecté ne veut pas dire être présent : début 2010, seules 58 % des sociétés d'au moins 10 salariés avaient un site web, la moitié parmi les 10 à 19 salariés contre plus de 90 % des 250 salariés ou plus (Insee Première n° 1353, 2011).
La France était alors nettement en dessous de la moyenne de l'Union européenne, qui atteignait 69 %.
La règle se lit dans ces chiffres : les grandes entreprises adoptent d'abord, parce qu'elles ont un service informatique, un budget et des concurrents qui les y poussent ; les petites suivent avec dix ans de décalage.
L'adoption s'est faite par vagues : la messagerie électronique et le site vitrine d'abord, puis la vente en ligne, puis le mobile et les réseaux sociaux dans les années 2010.
Le commerce en ligne illustre l'écart de rythme : Amazon ouvre au public le 16 juillet 1995 aux États-Unis et Amazon.fr le 31 août 2000, quand la moitié des petites sociétés françaises n'ont pas encore de site.
Pour un marketeur, ces courbes sont un premier outil de décision : savoir où en est l'adoption d'un canal dit s'il faut y investir maintenant, attendre, ou s'y précipiter avant les concurrents.
En 2026, la question n'est plus internet mais l'IA, et l'INSEE publie exactement le même type de courbe, que vous verrez au dernier titre de ce chapitre.
Les difficultés des salariés à maîtriser
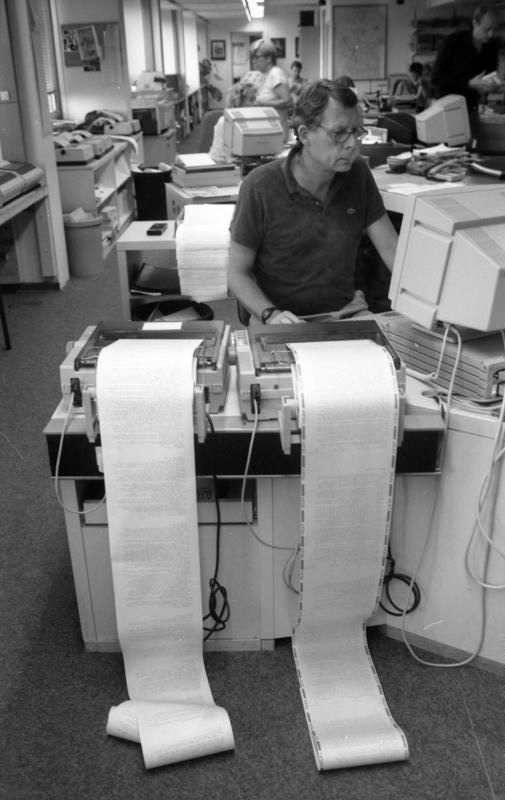

La photo ci-dessus montre une salle de rédaction en 1988 : les écrans sont arrivés, mais le téléscripteur crache encore ses rouleaux de papier, et l'organisation du travail n'a pas changé.
C'est le quotidien des entreprises depuis quarante ans : l'équipement précède la compétence.
En 1998, 51 % des salariés français utilisaient l'informatique dans leur travail, 60 % en 2005 (INSEE, L'évolution des conditions de travail, 2008), puis 71 % en 2013 et 79 % en 2019, d'après les enquêtes Conditions de travail de la Dares relayées par le Labo Société numérique.
Autrement dit, vingt ans après la généralisation du PC de bureau, un salarié sur cinq n'y touchait toujours pas.
Et parmi ceux qui l'utilisent, l'écart est immense entre le cadre qui construit un tableau de bord et l'employé qui saisit des références dans un écran figé.
L'INSEE parle d'illectronisme : en 2021, 15 % des personnes de 15 ans ou plus n'avaient pas les compétences numériques de base, et 28 % des internautes avaient des capacités faibles dans au moins un domaine, comme la recherche d'information, l'usage des logiciels ou la protection de la vie privée (Insee Première n° 1953, 2023).
Ces chiffres décrivent vos futurs clients et vos futurs collègues : un service marketing compte toujours des gens qui n'ouvrent jamais un tableur.
Les économistes ont un nom pour ce délai, le paradoxe de Solow, du nom du prix Nobel d'économie qui constatait en 1987 que l'on voyait l'ère informatique partout, sauf dans les statistiques de productivité.
Les gains sont arrivés, mais dix à quinze ans plus tard, quand les organisations ont réappris à travailler autour de l'outil et pas seulement avec.
Se former, tester et se tromper sur une nouvelle technologie n'est donc pas une perte de temps : à équipement égal, c'est ce qui sépare les salariés qui produisent de ceux qui subissent.
Les premiers ont profité de leur avantage, les autres sont restés à la ramasse
Le sociologue Everett Rogers a décrit en 1962 la diffusion des innovations : quelques innovateurs (2,5 %), des adopteurs précoces (13,5 %), puis deux majorités (34 % chacune) et des retardataires (16 %).
La courbe en cloche compte les nouveaux venus à chaque période ; la courbe en S, leur total cumulé, qui monte lentement, puis très vite, puis plafonne.
Le point qui compte pour un marketeur : quand la majorité arrive, les positions sont déjà prises par ceux qui étaient là avant.
Blockbuster exploitait 9 094 magasins de location de vidéos en 2004 et avait refusé, en 2000, de racheter Netflix pour 50 millions de dollars.
Blockbuster a déposé le bilan en 2010 ; Netflix, fondé en 1997, comptait 277 millions d'abonnés en juillet 2024.
Kodak avait mis au point la photo numérique dès 1975 et a déposé le bilan le 19 janvier 2012, faute d'avoir voulu cannibaliser sa pellicule.
Les vainqueurs ne sont pas ceux qui avaient la meilleure technologie, mais ceux qui l'ont adoptée pendant que les autres hésitaient.
L'avantage du premier est cumulatif : plus de clients donnent plus de données, plus de données donnent un meilleur service, et un meilleur service attire plus de clients.
C'est pourquoi Amazon, lancé en 1995 comme librairie en ligne, domine encore le commerce électronique trente ans plus tard.
À l'échelle d'une carrière, la même règle s'applique aux personnes : celui qui sait utiliser l'outil quand il arrive est promu, celui qui attend qu'il soit obligatoire le subit.
La suite de ce chapitre montre que ce scénario s'est rejoué avec un tableur, puis avec le logiciel par abonnement, et qu'il se rejoue en 2026 avec l'IA.
La même logique à chaque innovation : l'exemple d'Excel
Excel existe depuis 1985 sur Macintosh et 1987 sur Windows, et dès 1990 ses ventes dépassent celles de Lotus 1-2-3, le tableur dominant de la décennie précédente.
Dans les entreprises françaises, la suite Office est donc banale depuis les années 1990 : le logiciel était là.
Ce qui est resté rare pendant vingt ans, c'est de le maîtriser : les tableaux croisés dynamiques et le langage de macros VBA existent depuis Excel 5, en 1993, et restent en 2026 l'affaire d'une minorité de salariés.
Les chiffres de la Dares racontent ce décalage : en 1998, un salarié sur deux utilisait l'informatique ; en 2013, près d'un sur trois n'y touchait pas ; en 2019, encore un sur cinq, et beaucoup d'utilisateurs se limitent à la saisie.
Il n'existe pas de statistique publique sur la maîtrise d'Excel ; ce que l'on mesure, c'est la compétence numérique générale, et l'INSEE comptait encore 28 % d'internautes aux capacités faibles en 2021.
Le mécanisme est toujours le même, en trois temps : l'outil arrive, une minorité apprend à s'en servir vraiment, la majorité l'ignore ou l'utilise à 10 % pendant des années.
Pendant ce temps, la minorité prend l'avantage : le stagiaire qui automatise en une macro le rapport hebdomadaire que son voisin refait à la main chaque lundi.
Puis vient le troisième temps, où la compétence devient un prérequis : en 2026, la maîtrise d'Excel est attendue dans un poste en gestion, et personne ne vous y formera.
Excel lui-même s'apprend aujourd'hui avec l'IA : demandez-lui la formule, la macro ou le tableau croisé, elle l'écrit et l'explique.
promptJ'ai un fichier Excel avec une feuille « Ventes » (colonnes : date, magasin, produit, quantité, prix unitaire). Explique-moi pas à pas comment construire un tableau croisé dynamique qui donne le chiffre d'affaires par magasin et par mois. Ensuite, donne-moi la formule qui calcule la même chose sans tableau croisé, et explique chaque partie de la formule.
L'histoire ne dit pas quel outil sera le prochain ; elle dit que ceux qui l'apprennent quand il est encore facultatif ne sont jamais en retard.
Les modèles économiques du numérique : de la boîte au SaaS
Jusqu'aux années 2000, un logiciel s'achetait comme un livre : une boîte, des disquettes puis un CD, une licence payée une fois, et une nouvelle version à racheter tous les trois ans.
Salesforce, fondé en 1999, a fait campagne sur le slogan « No Software » : son logiciel de gestion de la relation client ne s'installe pas, on s'y connecte par le navigateur et on paie chaque mois, par utilisateur.
Ce modèle s'appelle le SaaS, software as a service ; le terme apparaît en 2001.
Le graphique montre ce qu'il rapporte : 176 millions de dollars de chiffre d'affaires en 2005, 1,3 milliard en 2010, 17 milliards en 2020 et 41,5 milliards sur l'exercice clos en janvier 2026.
Les éditeurs historiques ont basculé dans les années 2010 : Microsoft lance Office 365 le 28 juin 2011 (devenu Microsoft 365), et Adobe annonce le 6 mai 2013 qu'il ne vendra plus Photoshop en boîte pour imposer l'abonnement Creative Cloud.
Résultat : Adobe a réalisé 23,8 milliards de dollars de chiffre d'affaires sur son exercice 2025, dont 96 % en abonnements sur le dernier trimestre (communiqué du 10 décembre 2025), et Microsoft 365 comptait 89 millions d'abonnés grand public en juin 2025, sans compter les entreprises (résultats Microsoft).
Pour l'éditeur, l'abonnement est un rêve : un revenu récurrent et prévisible, qui ne dépend plus d'une décision d'achat tous les trois ans ; pour le client, c'est une dépense qui ne s'arrête jamais.
| Modèle | Comment on paie | Qui garde la valeur | Exemples |
|---|---|---|---|
| Logiciel en boîte | une licence, une fois, puis la version suivante | l'éditeur, à chaque version | Office 97, Photoshop CS |
| SaaS | un abonnement mensuel par utilisateur | l'éditeur, chaque mois | Salesforce, Microsoft 365, Creative Cloud |
| Outil sur mesure produit par une IA | le temps de calcul de l'IA, quelques euros | l'utilisateur qui sait formuler le besoin | le « Spotify-like » du chapitre « Je vous guide » |
Depuis 2025, ce modèle est contesté : une IA de programmation comme Claude Code construit en quelques minutes un outil sur mesure que l'on louait jusque-là par abonnement.
Les investisseurs l'ont compris brutalement : entre le 28 janvier et le 5 février 2026, l'indice des logiciels et services du S&P 500 a perdu environ 1 000 milliards de dollars de capitalisation, après qu'Anthropic a publié une extension de son IA capable de faire une partie du travail de logiciels spécialisés, juridiques notamment (Reuters, 5 février 2026).
Ce n'est pas la fin des éditeurs, qui intègrent tous l'IA à leur tour, mais la fin d'une rente : un service que l'on peut recréer soi-même ne se vend plus au même prix.
Vous verrez la démonstration au chapitre « Je vous guide » : un prompt, un fichier CSV, et un site de musique qui fonctionne du premier coup dans un dossier de votre ordinateur.
L'équivalent avec l'IA aujourd'hui
Vous connaissez la formule : l'IA ne va pas vous remplacer, mais quelqu'un qui maîtrise l'IA, si.
Elle a une origine attribuable : le 27 novembre 2017, au congrès des radiologues américains, le professeur Curtis Langlotz, de Stanford, répondait à Geoffrey Hinton, qui prédisait en 2016 la disparition des radiologues sous cinq ans, que les radiologues qui utilisent l'IA remplaceront ceux qui ne l'utilisent pas.
Neuf ans plus tard, les radiologues sont toujours là, et la phrase est devenue un adage appliqué à tous les métiers.
Elle décrit exactement le mécanisme des titres précédents : l'outil est là, la majorité ne le maîtrise pas, une minorité prend l'avantage.
Les chiffres de l'INSEE le montrent : 18 % des entreprises de 10 salariés ou plus implantées en France utilisaient au moins une technologie d'IA en 2025, contre 10 % en 2024 et 6 % en 2023 (Insee Première n° 2120, juillet 2026).
Comme pour internet, les grandes vont d'abord : 58 % des entreprises de 250 salariés ou plus, 31 % des 50 à 249 salariés, 15 % des 10 à 49 salariés.
L'Union européenne dans son ensemble est à 20 % en 2025, le Danemark à 42 % (Eurostat, décembre 2025).
Le frein n'est pas l'outil mais la compétence : plus de la moitié des entreprises utilisatrices déclarent être freinées par un manque d'expertise, et 54 % de celles qui n'utilisent pas l'IA invoquent le même manque, juste derrière l'absence d'utilité perçue (71 %).
Traduisez pour vous : en 2026, savoir faire travailler une IA est encore une compétence rare sur le marché du travail, comme le tableau croisé dynamique en 1995 ou le site web en 2000.
Ce ne sera plus le cas dans cinq ans ; ce sera un prérequis, comme Excel l'est devenu.
D'où ce cours : le reste de la séance vous fait manipuler ces outils, et le chapitre suivant explique les briques techniques sur lesquelles ils reposent.
Les technologies classiques
D'ARPANET aux IA : cinquante ans en une frise
Tout ce que vous utilisez en ligne repose sur une pile de technologies dont chaque étage a été posé à une date précise, et la frise ci-dessus en retient dix.
Le 29 octobre 1969, deux universités californiennes échangent le premier message sur ARPANET, un réseau financé par l'armée américaine pour relier une poignée d'ordinateurs.
Le 1er janvier 1983, ce réseau adopte TCP/IP, la règle commune qui permet à des réseaux différents de se parler, et le mot « Internet » prend son sens de réseau des réseaux.
Proposé en 1989 au CERN de Genève par Tim Berners-Lee, le Web, c'est-à-dire des pages reliées par des liens, fonctionne à la fin de 1990, et le CERN en libère le logiciel le 30 avril 1993.
Google naît en 1998, Amazon ouvre la location de serveurs en 2006, l'iPhone arrive en 2007 et GitHub en 2008 : en dix ans, le Web devient une économie.
Hugging Face est fondé en 2016 par trois Français à New York, et ChatGPT, lancé le 30 novembre 2022, fait entrer l'IA générative dans le grand public.
Le 25 novembre 2024, Anthropic publie le protocole MCP (Model Context Protocol), qui donne aux IA un moyen standard de brancher des outils et prépare l'IA agentique traitée plus loin dans cette séance.
Le point à retenir pour un marketeur n'est pas la chronologie, mais le fait que rien n'a été remplacé : les IA de 2026 passent toujours par TCP/IP, le DNS, HTTP et des API conçus il y a vingt à quarante ans.
Chaque titre qui suit prend un de ces étages et répond à trois questions : ce que c'est, à quoi cela vous servira, et pourquoi il faut le connaître même sans être technicien.
Dans la boîte : processeur, mémoire, carte graphique et les autres
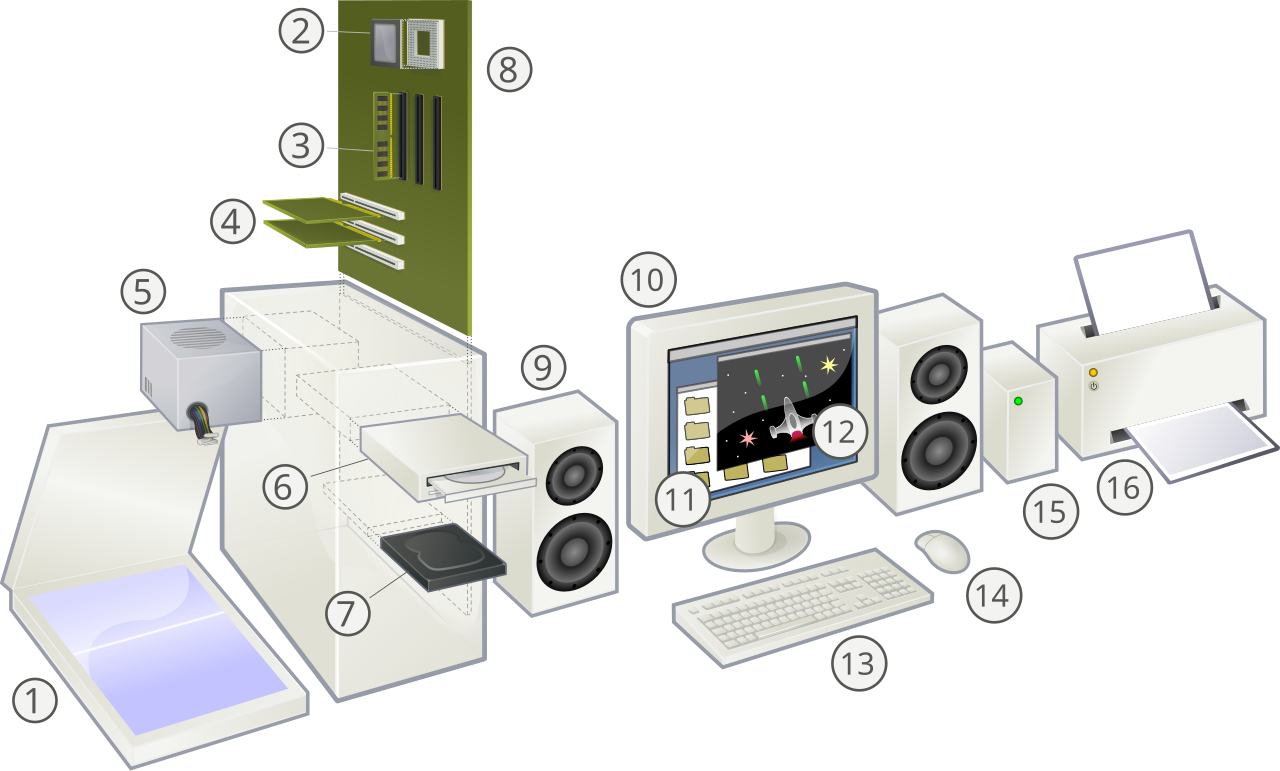

Un ordinateur, portable ou de bureau, est toujours le même assemblage de six pièces, et savoir les nommer suffit pour lire une fiche produit ou comprendre pourquoi un logiciel refuse de s'installer.
Le processeur (CPU) exécute les instructions une à une, très vite ; il est bon pour tout, excellent pour rien, et c'est lui qui fait tourner Windows, le navigateur et Excel.
La mémoire vive (RAM) est l'espace de travail : tout ce qui est ouvert y est chargé, elle se vide à l'extinction, et un portable de 2026 en embarque 16 ou 32 gigaoctets.
Le SSD conserve les fichiers quand la machine est éteinte ; il a remplacé le disque dur à plateaux, cent fois plus lent, et se compte en centaines de gigaoctets ou en téraoctets.
La carte graphique (GPU) contient des milliers de petits cœurs qui font tous le même calcul en parallèle : conçue pour afficher les jeux en 3D, elle s'est révélée être la machine idéale pour entraîner et faire tourner les réseaux de neurones.
La carte mère relie tout cela par des bus, et le bloc d'alimentation transforme le 230 volts de la prise en tensions continues, avec des ventilateurs pour évacuer la chaleur.
Chaque pièce a sa mémoire attitrée : le processeur travaille dans la RAM, la carte graphique dans sa propre mémoire vidéo (VRAM), soudée sur la carte, et les deux se parlent par un bus plus lent.
C'est ce détail qui décide de ce qu'une machine peut faire en IA : un modèle doit tenir entièrement dans la mémoire de la puce qui le calcule, sinon il ne tourne pas ou tourne au ralenti.
Retenez l'ordre de grandeur : un PC portable ordinaire n'a pas de carte graphique dédiée, un PC de joueur en a une avec 8 à 16 gigaoctets de VRAM, et la meilleure carte grand public de 2026, la RTX 5090, en a 32.
Le système d'exploitation (Windows, macOS, Linux, ChromeOS, iPadOS) est la couche logicielle qui pilote ces pièces et décide de ce que vous avez le droit d'installer dessus ; c'est l'objet du titre suivant.
Chromebook, tablette, Mac : le matériel et le système décident de ce que vous pouvez installer
Beaucoup d'entre vous ont un Chromebook ou une tablette, et il faut le dire simplement : ce sont d'excellentes machines pour lire, écrire et naviguer, et de mauvaises machines pour ce cours.
Le problème est d'abord matériel : 4 ou 8 gigaoctets de mémoire, un stockage réduit, pas de carte graphique dédiée, donc pas de place pour faire tourner un modèle en local.
Il est ensuite logiciel : ChromeOS est construit autour du navigateur et iPadOS n'installe que des applications de l'App Store, sans terminal ni accès aux fichiers du système, alors que les outils du chapitre « Je vous guide », Claude Code et Ollama, sont des programmes qu'on installe et qu'on pilote depuis un terminal.
Un PC Windows ordinaire fait l'affaire pour les petits modèles ; pour les plus gros, il faut une carte graphique avec beaucoup de mémoire vidéo, et c'est là que le Mac a changé la donne.
Jusqu'en 2020, Apple achetait ses processeurs à Intel comme tout le monde ; le 10 novembre 2020, elle sort le M1, sa propre puce, conçue en interne et fabriquée par TSMC, et bascule toute sa gamme en deux ans.
La différence décisive s'appelle la mémoire unifiée : processeur et carte graphique sont gravés sur la même puce et partagent une seule mémoire, au lieu des deux mémoires séparées d'un PC.
La conséquence est simple : sur un Mac, la carte graphique voit toute la mémoire de la machine, et un modèle d'IA de 60 gigaoctets tient dans un portable à 64 gigaoctets, là où la meilleure carte grand public pour PC plafonne à 32.
Le Mac Studio à puce M3 Ultra, sorti en mars 2025, monte jusqu'à 512 gigaoctets de mémoire unifiée, et la presse spécialisée y a fait tourner un modèle de 671 milliards de paramètres, DeepSeek R1, à 17 à 18 mots par seconde, dans une boîte posée sur un bureau.
C'est la raison pour laquelle ma démonstration se fait sur un Mac, et la raison pour laquelle, à budget égal, un développeur ou un chercheur en IA choisit souvent un Mac plutôt qu'un PC.
Ce n'est pas une publicité : un PC avec une bonne carte graphique reste plus rapide pour un petit modèle et coûte moins cher, mais dès que le modèle grossit, la question n'est plus la vitesse, c'est la place.
Pour vous, en L2, le message est celui-ci : les modèles gratuits du chapitre « Je vous guide » tournent sur un PC ou un Mac récent avec 16 gigaoctets ; sur un Chromebook ou une tablette, vous passerez par les versions en ligne, ce qui suffit pour suivre le cours.
Cartes grand public et cartes de centre de données : la RTX 5090 face à la H100
La puissance d'une puce se mesure en FLOPS, opérations en virgule flottante par seconde ; un téraflop (TFLOPS), c'est mille milliards d'opérations par seconde.
La meilleure carte qu'un particulier peut acheter en 2026, la GeForce RTX 5090 de Nvidia, sortie le 30 janvier 2025 à 1 999 dollars, affiche 104,8 TFLOPS en calcul classique (FP32), 32 gigaoctets de mémoire et consomme 575 watts.
La carte de centre de données que les géants s'arrachent, la H100 du même Nvidia, n'affiche que 67 TFLOPS en FP32 : sur ce chiffre-là, la carte de joueur gagne.
Mais l'IA ne calcule pas en FP32 : elle utilise des nombres plus courts (FP16, BF16, et maintenant FP8 et FP4) sur des unités spécialisées, les cœurs Tensor, et là l'écart s'inverse, 209,5 TFLOPS pour la 5090 contre 989 pour la H100, près de cinq fois plus.
L'écart est surtout dans la mémoire : 80 gigaoctets de HBM3 à 3 350 gigaoctets par seconde contre 32 gigaoctets à 1 792, parce qu'un grand modèle est d'abord un problème de place et de débit, comme on l'a vu au titre précédent.
Enfin, la H100 est faite pour travailler en troupeau : le lien NVLink à 900 gigaoctets par seconde relie huit cartes dans un serveur, puis des milliers de serveurs entre eux, ce qu'une carte de joueur ne sait pas faire.
Le prix suit : environ 30 000 dollars la carte selon les estimations de CNBC, quinze fois une 5090, pour un objet qui n'affiche même pas d'image sur un écran.
Le 18 janvier 2024, Mark Zuckerberg annonce que Meta possédera 350 000 H100 à la fin de l'année, soit environ 600 000 « équivalents H100 » en comptant les autres cartes : à 30 000 dollars pièce, c'est plus de 10 milliards de dollars de cartes graphiques pour une seule entreprise.
Ce chiffre explique à lui seul le titre « Nvidia, grand vainqueur » du chapitre sur l'IA : quand quatre ou cinq entreprises achètent chacune des centaines de milliers de cartes à ce prix, le fabricant de cartes devient la première capitalisation mondiale.
Nvidia a depuis sorti la génération suivante, Blackwell (B200), sur le même principe, encore plus de mémoire et de débit, et les commandes se sont poursuivies.
Pour un gestionnaire, la leçon est économique : la puissance de calcul est devenue une matière première, achetée par lots de dizaines de milliers d'unités, et son coût décide de qui peut entraîner un grand modèle, c'est-à-dire de qui fixe les règles du secteur.
Le réseau et ses protocoles : TCP/IP et DNS
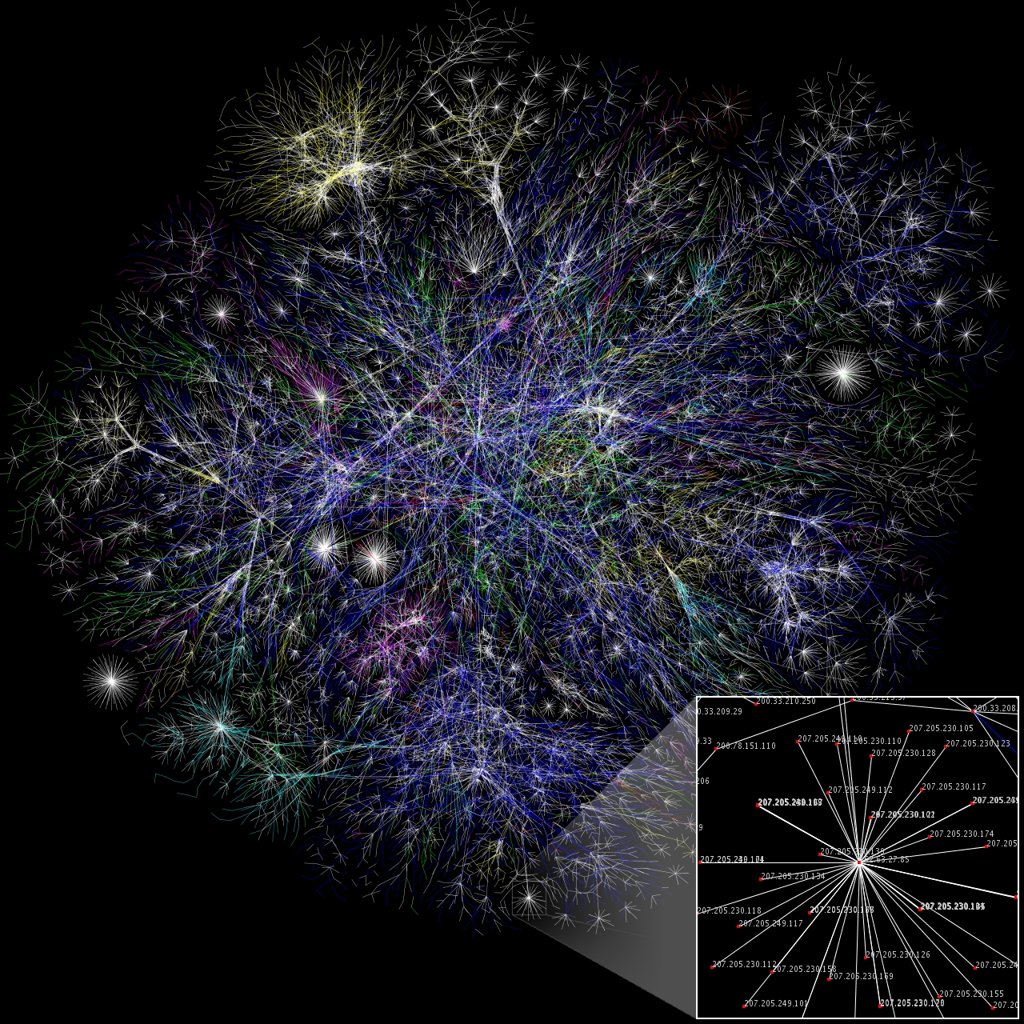
Internet est un réseau de réseaux : celui de votre opérateur mobile, celui de l'université, celui d'Amazon, reliés entre eux par des accords d'échange et des câbles, sous-marins compris.
Pour que des machines aussi différentes se comprennent, il faut des protocoles, c'est-à-dire des règles écrites qui fixent la forme des messages et l'ordre des échanges.
TCP/IP est le socle : IP donne à chaque machine connectée une adresse numérique et achemine les données par petits paquets, TCP vérifie que tous les paquets arrivent et les remet dans l'ordre.
Le DNS (Domain Name System) est l'annuaire qui traduit un nom lisible comme uca.fr en adresse IP, parce que personne ne retient une suite de chiffres.
Ce nom de domaine est loué, pas acheté : l'AFNIC gère les .fr, et une marque qui oublie de renouveler le sien peut le voir racheté par un concurrent ou un escroc.
Concrètement, quand un client tape votre adresse, son appareil interroge d'abord le DNS, puis ouvre une connexion TCP vers l'adresse IP obtenue, et seulement ensuite demande la page.
Pour un marketeur, deux conséquences pratiques : le choix et la protection du nom de domaine sont une décision de marque, et une panne DNS rend un site invisible même s'il fonctionne parfaitement.
L'ARCEP, le régulateur français des télécoms, publie chaque année l'état de ce réseau en France, débits et abonnements compris.
Vous n'aurez jamais à configurer TCP/IP, mais vous saurez désormais ce que veut dire « le DNS ne répond pas » quand l'agence vous l'annonce un jour de lancement.
HTTP, HTTPS et le cadenas
HTTP (HyperText Transfer Protocol) est la langue dans laquelle un navigateur demande une page et un serveur la renvoie, comme le schéma ci-dessus le résume.
La requête dit ce qu'on veut (GET /produits/chaussures) ; la réponse commence par un code à trois chiffres, puis contient la page.
Ces codes valent la peine d'être connus : 200 signifie que tout va bien, 301 que la page a déménagé, 404 qu'elle n'existe pas, 500 que le serveur a planté.
Un rapport d'audit SEO qui liste des « erreurs 404 » parle simplement de liens vers des pages disparues, ce qui fait fuir les visiteurs et les moteurs de recherche.
HTTPS est la même chose, mais chiffrée : entre votre appareil et le serveur, personne ne peut lire ni modifier ce qui passe, ni le wifi du café ni l'opérateur.
Le cadenas du navigateur signifie deux choses précises : la connexion est chiffrée, et un certificat atteste que vous parlez bien au serveur du domaine affiché.
Il ne signifie pas que le site est honnête : un site d'hameçonnage en HTTPS affiche exactement le même cadenas, et cybermalveillance.gouv.fr rappelle que c'est l'adresse qu'il faut lire, pas le symbole.
Depuis décembre 2015, Let's Encrypt délivre ces certificats gratuitement, ce qui a rendu le HTTPS quasi universel ; un site sans cadenas en 2026 est un signal de négligence, et Chrome l'affiche comme « non sécurisé ».
Pour vous, la règle est simple : un site marchand, un formulaire de contact, une page de collecte d'e-mails doivent être en HTTPS, sinon les clients partent et les moteurs de recherche le pénalisent.
Le web : navigateur, serveur, URL
Le Web est l'ensemble des pages reliées par des liens ; il circule sur Internet, mais n'est qu'un de ses usages, comme le courrier électronique ou la vidéo en direct.
Le navigateur (Chrome, Safari, Firefox, Edge) est le logiciel qui envoie les requêtes HTTP, reçoit le HTML et l'affiche ; en août 2026, Chrome détient 69 % du marché mondial et Safari 16 % selon StatCounter.
Le serveur est un ordinateur allumé en permanence, chez un hébergeur, qui attend les requêtes et répond ; le chapitre suivant montre comment on fabrique ce qu'il envoie.
L'URL est l'adresse complète d'une page, et le schéma ci-dessus la découpe : le protocole, le nom de domaine, le chemin, puis les paramètres après le point d'interrogation.
Ces paramètres sont l'outil de travail du marketing digital : les paramètres UTM (utm_source, utm_campaign) ajoutés à un lien servent à savoir de quelle campagne vient un visiteur.
Un lien partagé sur Instagram, dans une newsletter et dans une publicité Google renverra vers la même page avec trois URL différentes, et c'est ainsi qu'on mesure chaque canal.
Le nom de domaine porte la confiance : « iae.uca.fr » dit que la page appartient à l'université, alors que « uca-fr.info » ne le garantit pas, quel que soit le logo affiché.
Un raccourcisseur de liens (bit.ly, ou celui de LinkedIn) masque cette adresse, ce qui est pratique mais oblige le lecteur à faire confiance sans voir où il va.
Savoir lire une URL est donc une compétence de marketeur autant que de citoyen : elle dit qui parle, à quelle page, et depuis quel canal.
Les API : une adresse qui répond des données
Une API (Application Programming Interface) est une adresse web qui, au lieu de renvoyer une page mise en forme, renvoie des données brutes destinées à un programme.
L'exemple du schéma est réel : l'adresse geo.api.gouv.fr/communes?nom=Clermont-Ferrand répond en une fraction de seconde le code INSEE 63113, la population de 146 351 habitants et les deux codes postaux.
Vous pouvez la coller dans votre navigateur pour voir le résultat : ce texte entre accolades est du JSON, le format traité plus loin.
Les marketeurs utilisent des API tous les jours sans le savoir : la carte du magasin sur le site vient de l'API de Google Maps, le paiement passe par celle de Stripe, la publication programmée sur Instagram par celle de Meta.
Le bouton « Se connecter avec Google » est aussi une API, encadrée par le protocole OAuth : le site ne voit jamais votre mot de passe, Google lui confirme seulement votre identité et lui transmet ce que vous acceptez.
Une API se paie souvent à l'appel : Google Maps offre en 2026 un millier d'appels gratuits par mois et par service, puis facture à l'usage, ce qui explique qu'un site à fort trafic surveille ce poste de coût.
Chaque API est décrite dans une documentation publique, et celle de Spotify permet par exemple de lire une playlist, ce qu'utilise l'export dont nous nous servirons pour le projet Mélodie.
Pour un gestionnaire, l'API est ce qui permet à deux logiciels de se parler sans ressaisie : la commande passée sur la boutique en ligne apparaît dans le logiciel de facturation puis dans le CRM sans qu'un humain recopie quoi que ce soit.
C'est aussi par des API que les IA agentiques agissent : quand un agent réserve un créneau ou lit une feuille de calcul, il appelle une adresse qui répond des données, exactement comme dans le schéma.
Le site api.gouv.fr recense les API publiques de l'État, dont l'annuaire des entreprises et les données géographiques, gratuites et utilisables sans autorisation pour la plupart.
Les bases de données : tables, clés, SQL
| id_client | nom | ville | inscrit_le |
|---|---|---|---|
| 1001 | Martin | Clermont-Ferrand | 2025-02-11 |
| 1002 | Martin | Riom | 2025-09-03 |
| 1003 | Diallo | Issoire | 2026-01-20 |
| id_commande | id_client | date | montant |
|---|---|---|---|
| 5001 | 1002 | 2026-03-02 | 49,90 |
| 5002 | 1001 | 2026-03-02 | 120,00 |
| 5003 | 1002 | 2026-04-15 | 15,50 |
Une base de données est un ensemble de tables, et une table ressemble à une feuille Excel disciplinée : des colonnes au nom fixe, un type par colonne, une ligne par enregistrement.
Dans l'exemple ci-dessus, la table des clients a une clé primaire, id_client, qui identifie chaque personne sans ambiguïté, même si deux clients s'appellent Martin.
La table des commandes reprend cette clé : c'est une clé étrangère, et c'est elle qui permet de répondre à « combien a dépensé le client 1002 » sans jamais recopier son nom.
Ce modèle relationnel, publié par Edgar Codd en 1970, fait tourner l'essentiel du monde : les banques, la SNCF, Shopify, votre dossier étudiant.
SQL (Structured Query Language) est la langue pour interroger ces tables, et une requête tient en une phrase.
sqlSELECT clients.ville, SUM(commandes.montant) AS chiffre_affaires
FROM commandes JOIN clients ON commandes.id_client = clients.id_client
GROUP BY clients.ville;
Cette requête donne le chiffre d'affaires par ville, et une IA l'écrit pour vous si vous lui décrivez les tables et la question.
Un CRM comme Salesforce ou HubSpot n'est rien d'autre qu'une base de données de ce type, avec une table des contacts, une table des échanges et une interface agréable par-dessus.
Les logiciels qui gèrent ces bases s'appellent PostgreSQL, MySQL ou SQLite ; ce dernier tient dans un simple fichier et c'est lui que Claude choisira le plus souvent pour un petit projet.
Ce qui compte pour un décideur, ce n'est pas d'écrire du SQL, c'est de savoir que la qualité d'une analyse dépend des clés : un client saisi deux fois, une ville orthographiée de trois façons, et les chiffres par ville sont faux.
La séance sur les études reviendra sur ce point, mais dès maintenant, retenez qu'une donnée sans identifiant fiable ne se croise avec rien.
Le cloud : louer des serveurs
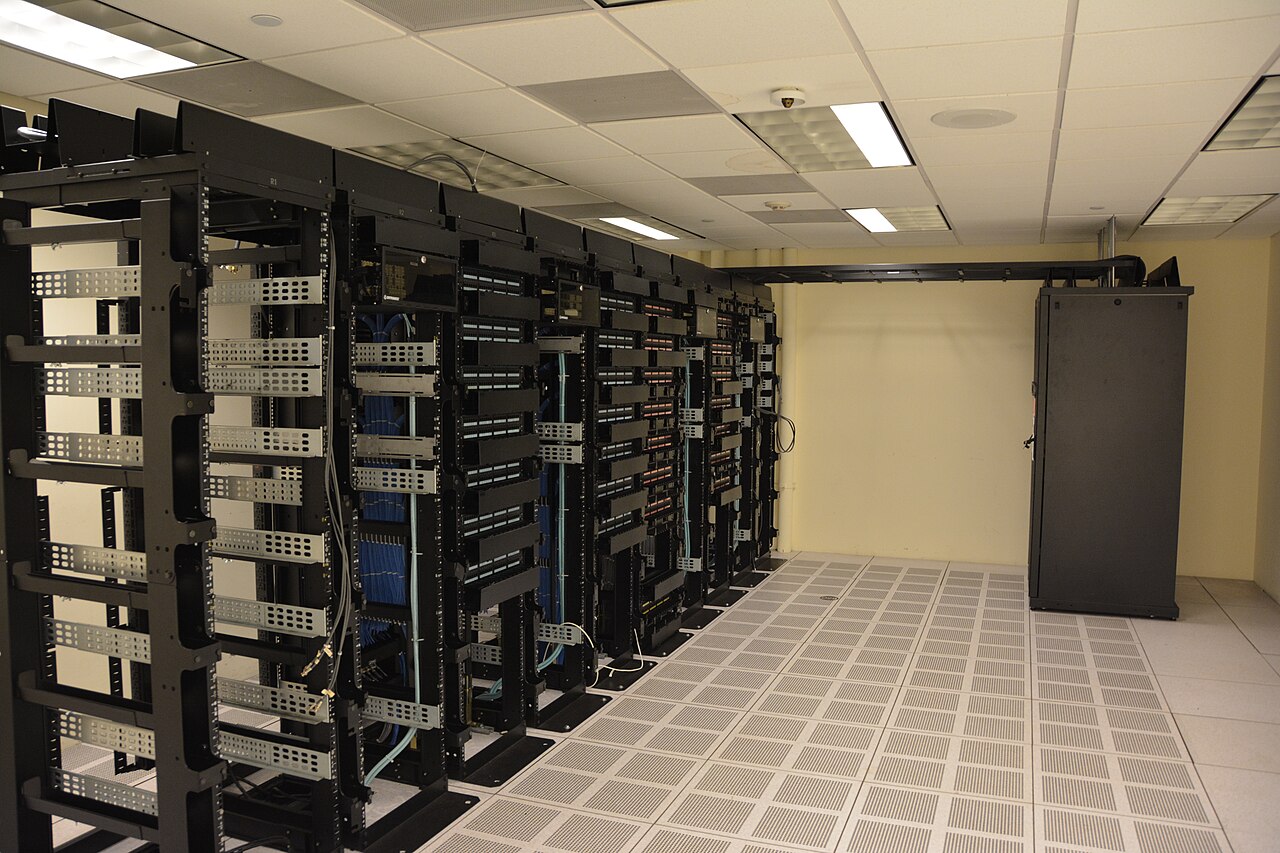
Le cloud n'a rien de vaporeux : ce sont des bâtiments remplis de serveurs comme ceux de la photo, que l'on loue à l'heure au lieu de les acheter et de les installer dans un local.
Amazon a ouvert cette location en 2006 avec Amazon Web Services, d'abord pour rentabiliser ses propres machines, et le modèle s'est imposé.
Au deuxième trimestre 2026, les entreprises ont dépensé 143 milliards de dollars en services cloud, dont 28 % chez Amazon, 20 % chez Microsoft (Azure) et 15 % chez Google Cloud selon Synergy Research (30 juillet 2026).
Pour une entreprise, l'intérêt est l'élasticité : un site marchand loue dix fois plus de serveurs pendant le Black Friday et les rend le lundi suivant, sans avoir acheté de matériel.
Le cloud, c'est aussi les logiciels servis depuis ces serveurs : Gmail, Canva, Notion, Shopify ou un CRM sont du SaaS, vous n'installez rien, vous payez un abonnement.
Le revers est la dépendance : vos données sont chez un fournisseur, le plus souvent américain, et le chapitre sur le cadre légal montrera pourquoi le lieu d'hébergement compte au regard du RGPD.
Des acteurs européens existent, OVHcloud à Roubaix est le plus connu, et Hostinger, que je vous montrerai en fin de séance, loue de petits serveurs pour quelques euros par mois.
Les IA vivent dans ce cloud : chaque réponse de ChatGPT ou de Claude est calculée dans un centre de données, et c'est pourquoi la question de l'énergie revient dans le chapitre sur l'avis du public.
Vous rencontrerez le cloud sous forme de facture : quand une start-up dit « brûler 3 000 euros par mois d'AWS », elle parle de cette location, et c'est un poste que le marketing fait varier avec le trafic qu'il génère.
GitHub, Hugging Face et le logiciel libre
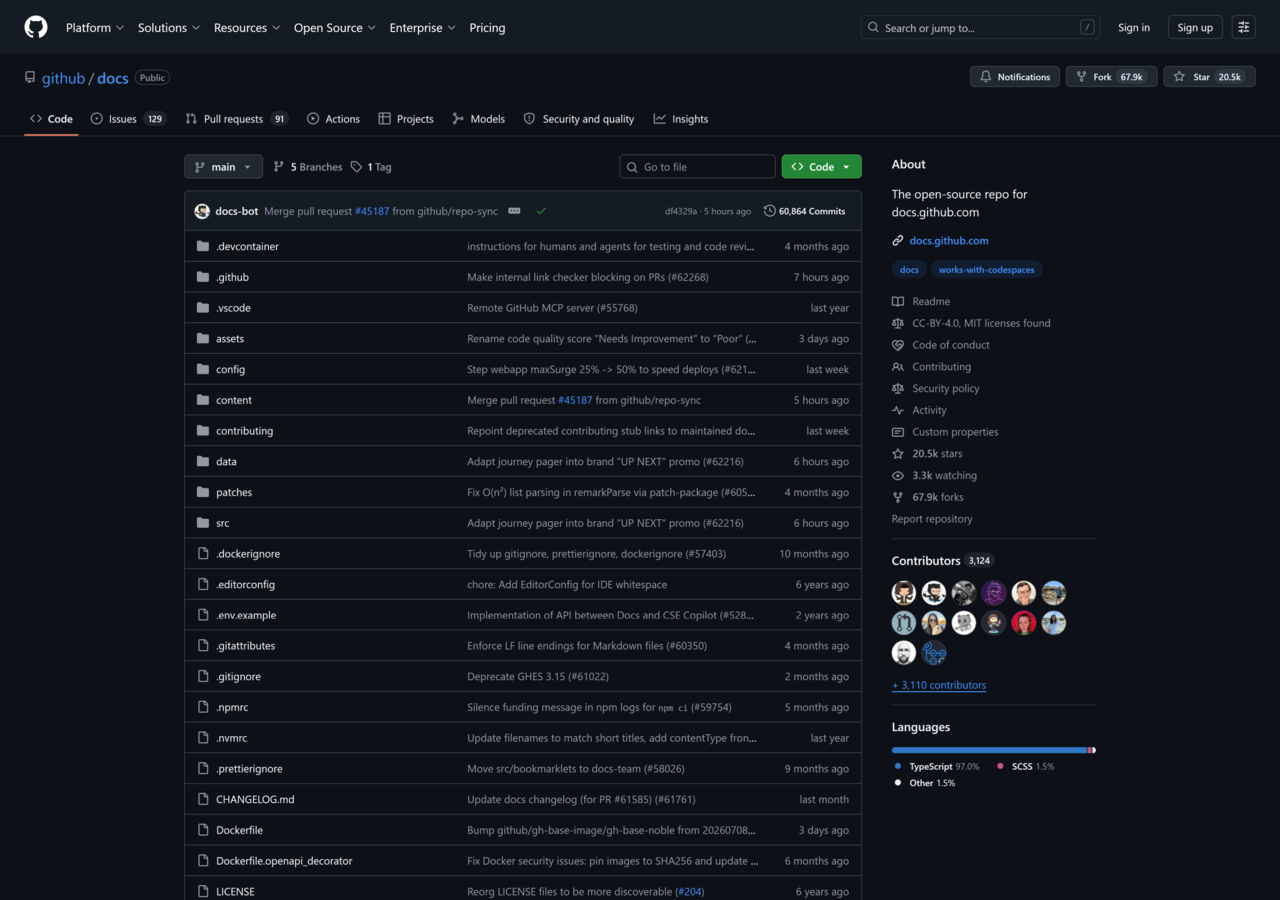
Un logiciel est un texte, et GitHub est l'endroit où ce texte est rangé, versionné et partagé : chaque projet y est un dépôt, comme celui de la capture.
Fondé en 2008 et racheté par Microsoft en 2018 pour 7,5 milliards de dollars, GitHub compte plus de 180 millions de développeurs et 630 millions de dépôts selon son rapport Octoverse du 28 octobre 2025.
Un dépôt public est lisible par tous, et le plus souvent sous une licence libre : vous pouvez copier le code, l'utiliser, le modifier, à condition en général de citer l'auteur.
Le logiciel libre est né en 1983 avec Richard Stallman et le projet GNU, autour de quatre libertés : utiliser, étudier, modifier, redistribuer.
Vous en utilisez chaque jour sans le voir : Linux équipe 62 % des sites web dont le système est connu selon W3Techs (14 septembre 2026) et se cache dans Android, VLC est né à l'École centrale Paris, Firefox et WordPress sont libres.
GitHub Pages héberge gratuitement un site à partir d'un dépôt, et c'est ce que vous utiliserez si vous mettez en ligne un projet de cette séance sans payer d'hébergeur.
Hugging Face joue le même rôle pour l'IA : c'est l'entrepôt où les modèles ouverts sont déposés, décrits et téléchargés, avec plus de trois millions de modèles recensés au 14 septembre 2026.
C'est là que Meta publie Llama, que Mistral AI dépose ses modèles français, et que l'on trouve les modèles qu'Ollama télécharge quand vous tapez une commande sur votre ordinateur.
Pour un marketeur, ces plateformes changent le coût d'entrée : un outil de nettoyage de données ou un modèle de classification de commentaires existe déjà, gratuit, avec sa documentation, et l'IA sait le trouver et l'installer.
Le chapitre sur les acteurs de l'IA reviendra sur le partage entre modèles ouverts et modèles privés ; ici, retenez qu'open source désigne un code que chacun peut lire, ce qui est une garantie de transparence, pas de qualité.
Le format des données : CSV et JSON
Une donnée doit être écrite quelque part, et deux formats texte suffisent pour presque tout : le CSV pour les tableaux, le JSON pour les données structurées que s'échangent les programmes.
Un fichier CSV (Comma-Separated Values) est un tableau à plat : une ligne d'en-têtes, puis une ligne par enregistrement, les colonnes séparées par une virgule ou, en France, un point-virgule.
Ce détail du séparateur est le premier piège : Excel en français attend un point-virgule, et un CSV américain ouvert sans précaution met tout dans une seule colonne.
Le JSON (JavaScript Object Notation) écrit des paires clé-valeur entre accolades, qui peuvent s'imbriquer : c'est ce que renvoient les API et ce que produisent la plupart des exports « télécharger mes données ».
Un export de playlist Spotify via Exportify est un CSV avec une ligne par titre : nom, artiste, album, durée, date d'ajout, popularité ; c'est ce fichier que je donnerai à Claude pour reconstruire Mélodie.
L'export des commandes de Shopify est aussi un CSV, avec une ligne par article commandé, le client, l'adresse, le montant, la date, le canal ; c'est la matière des tableaux de bord que construisent les étudiants de master.
Le RGPD vous donne un droit à la portabilité : tout service doit pouvoir vous rendre vos données dans un format structuré et lisible par machine, et c'est presque toujours du CSV ou du JSON.
Testez-le : Spotify, Instagram, Google ou Netflix proposent tous un téléchargement de vos données dans leurs réglages de confidentialité, et ce que vous y trouverez éclaire le chapitre sur les traces.
Pour une IA, ces deux formats sont un langage natif : donnez-lui un CSV et une question, et elle écrit le code Python qui répond ; donnez-lui un JSON, et elle vous explique ce qu'il contient.
La compétence attendue d'un gestionnaire n'est pas de manipuler ces fichiers à la main, mais de savoir demander « l'export CSV des commandes du trimestre » et de vérifier que les colonnes disent ce qu'on croit.
Le courrier électronique, le plus vieux canal marketing
Le courrier électronique est plus vieux que le Web : son protocole d'envoi, SMTP, date de 1982, et il reste en 2026 le seul canal marketing dont vous possédez la liste de destinataires.
Sur Instagram ou TikTok, vos abonnés appartiennent à la plateforme, qui décide qui voit vos publications ; une liste d'e-mails, vous l'emportez si vous changez d'outil.
Le trajet est celui du schéma : votre outil d'emailing envoie via SMTP, le serveur du destinataire reçoit, filtre, puis range le message dans la boîte de réception ou dans le spam, où le lecteur le consulte via IMAP ou une application.
Ce filtrage repose sur trois signatures techniques, SPF, DKIM et DMARC, qui prouvent que le message vient bien du domaine affiché et n'a pas été modifié en route.
Depuis le 1er février 2024, Google impose aux expéditeurs de plus de 5 000 messages par jour ces signatures, un lien de désinscription en un clic et un taux de plainte pour spam inférieur à 0,3 %.
Un marketeur qui ignore ces règles voit ses campagnes disparaître dans le spam sans aucun message d'erreur, et la « délivrabilité » est devenue un métier à part entière.
Des outils comme Brevo, entreprise française, ou Mailchimp gèrent la technique, mesurent les ouvertures et les clics, et refusent les listes achetées, qui détruisent la réputation de l'expéditeur.
Le même protocole sert aux escrocs : l'hameçonnage est un e-mail qui imite une marque, et Signal Spam, la plateforme française de signalement, permet à chacun de le dénoncer.
Retenez le paradoxe : le canal le moins spectaculaire est celui que vous contrôlez le mieux, précisément parce qu'il repose sur une liste que vous avez construite et sur des règles techniques que vous respectez.
Les moteurs de recherche et leurs robots
Google traite 91 % des recherches dans le monde en août 2026 selon StatCounter, et son fonctionnement en trois temps est documenté par Google lui-même : explorer, indexer, classer.
Explorer : un robot, Googlebot, parcourt le Web de lien en lien et lit chaque page qu'il rencontre, comme un lecteur infatigable qui ne voit que le texte et les liens.
Indexer : ce qu'il a lu est rangé dans un index géant, et une page absente de l'index n'existe pas pour le moteur, même si elle est en ligne.
Classer : à chaque recherche, le moteur choisit et ordonne les pages de l'index, et c'est sur ce classement que travaille le référencement naturel, le SEO dont parle le chapitre sur les traces digitales.
Un fichier nommé robots.txt, à la racine de chaque site, dit aux robots ce qu'ils peuvent lire ; il repose sur leur bonne volonté, depuis 1994.
Depuis 2023, de nouveaux robots parcourent le même Web : GPTBot d'OpenAI, ClaudeBot d'Anthropic et d'autres lisent les pages pour entraîner les modèles ou répondre en direct.
Common Crawl, une fondation qui copie le Web depuis 2008 et met l'archive à disposition, a servi de matière première aux premiers grands modèles de langage.
La différence pour un site est brutale : le moteur classique renvoie un clic, le robot d'IA rédige une réponse et n'en renvoie presque pas ; Cloudflare, qui protège une grande partie du Web, a choisi le 1er juillet 2025 de bloquer par défaut les robots d'IA.
Pour le marketing, la question de 2026 n'est plus seulement « comment être premier sur Google », mais « comment être cité par l'IA qui répond à la place de Google », ce que l'on appelle désormais le GEO.
Cette séance ne vous demande pas d'optimiser quoi que ce soit, mais de comprendre que votre site a deux lecteurs qui ne sont pas humains, et qu'ils ne lisent que ce qui est écrit en clair.
Comment marche un site web (celui-ci, par exemple)
Ce qui se passe quand vous tapez l'adresse de ce site
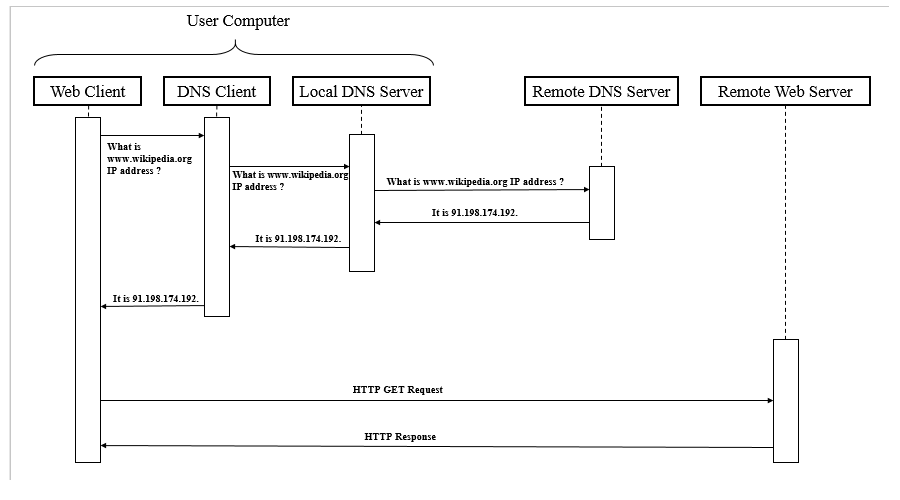

Quand vous tapez l'adresse de ce site et que vous validez, il ne se passe rien de magique : votre ordinateur envoie une demande, et un autre ordinateur lui répond.
Votre navigateur (Chrome, Safari, Firefox) est le client ; la machine qui détient les fichiers du site est le serveur, un ordinateur allumé en permanence dans un centre de données, et cet échange s'appelle le mode client-serveur.
Première étape, invisible : le nom que vous avez tapé ne veut rien dire pour le réseau, qui ne connaît que des adresses IP, des suites de nombres du type 145.223.10.42.
Un annuaire mondial, le DNS (Domain Name System, spécifié en 1983), traduit donc le nom de domaine en adresse IP, en quelques millisecondes.
Deuxième étape : votre navigateur envoie au serveur une requête HTTP, en pratique HTTPS, la version chiffrée qui affiche le cadenas dans la barre d'adresse.
Le serveur, chez Hostinger dans le cas de ce site, répond en renvoyant un simple fichier texte, index.html.
Le navigateur lit ce fichier, y découvre qu'il a aussi besoin d'une feuille de style, d'un petit script et de quelques images, et les demande une par une.
Il assemble le tout et dessine la page que vous lisez ; sur une connexion correcte, l'ensemble prend moins d'une seconde.
Tout cela transite par Internet, le réseau qui relie votre box, les opérateurs et le centre de données ; le Web n'est pas Internet, les pages ne sont qu'un usage du réseau, au même titre que le mail ou la vidéo à la demande, comme l'explique le dossier « Internet » d'Interstices (INRIA).
Pour un gestionnaire, deux conséquences : chaque visite laisse une trace sur le serveur (adresse IP, page demandée, heure), matière du chapitre sur les traces digitales, et un site n'existe que tant que quelqu'un paie un serveur pour le garder allumé.
Ce site est le cas le plus simple : le serveur envoie exactement les mêmes fichiers à chacun des 300 étudiants, sans compte, sans mot de passe et sans cookie.
La page « Comment fonctionne le Web » de Mozilla raconte la même histoire avec un peu plus de détails, en français.
HTML, CSS, JavaScript : les trois briques de toute page
| Brique | Depuis | Son rôle | Sur ce site |
| HTML | 1991 | La structure : titres, paragraphes, liens, images | 5 fichiers .html, un par page |
| CSS | 1996 | L'apparence : couleurs, polices, marges, écran de téléphone | assets/style.css, 27 Ko |
| JavaScript | 1995 | Le comportement : réagir à un clic, ouvrir, vérifier | assets/site.js, 2 Ko |
Ouvrez n'importe quelle page de ce site, faites un clic droit puis « Afficher le code source » : vous verrez un fichier texte, pas un programme mystérieux.
Voici cinq lignes du fichier index.html, la page d'accueil, telles qu'elles sont sur le serveur.
html<title>Fondements du Marketing</title>
<link rel="stylesheet" href="assets/style.css">
<script defer src="assets/site.js"></script>
<h1>Fondements du Marketing</h1>
<p class="accroche">Le site du cours : les concepts de chaque séance, les cas faits en amphi, et tout ce qu'il faut savoir sur l'examen.</p>
Le HTML (HyperText Markup Language, annoncé par Tim Berners-Lee en août 1991) donne la structure : un titre entre <h1> et </h1>, un paragraphe entre <p> et </p>, un lien, une image.
Ces mots entre chevrons sont des balises, des étiquettes qui disent au navigateur ce qu'est chaque morceau de texte, et non à quoi il doit ressembler.
Le CSS (Cascading Style Sheets, première version le 17 décembre 1996) s'occupe de l'apparence : couleurs, polices, marges, colonnes, et l'adaptation à un écran de téléphone.
La deuxième ligne du code ci-dessus dit au navigateur d'aller chercher le fichier assets/style.css, 27 Ko de règles qui habillent les cinq pages du site.
Le JavaScript (créé par Brendan Eich chez Netscape, première version le 4 décembre 1995) ajoute le comportement : réagir à un clic, ouvrir un menu, vérifier un formulaire avant l'envoi.
Ici il tient en 2 Ko et fait trois petites choses : le bouton « Copier » des blocs de code, le dépliage des volets, et la correction des questions à choix quand une page en contient.
Ces trois briques sont des standards ouverts, gratuits, compris par tous les navigateurs sans licence à acheter, et c'est ce qui a permis au Web de se répandre partout.
Une page comme celle-ci pèse quelques dizaines de Ko de texte ; ce sont les images et les vidéos qui font le poids et la lenteur d'un site.
Vous n'avez pas à savoir écrire ces langages ; vous devez savoir qu'ils existent, à quoi sert chacun, et reconnaître un fichier .html quand une IA vous en produit un.
La documentation de référence en français est celle de Mozilla : HTML, CSS et JavaScript.
Les façons historiques de faire un site : WordPress et les autres CMS
Écrire les trois briques à la main pour chaque page, c'est ainsi que l'on faisait dans les années 1990 ; dès qu'un site dépasse dix pages et deux rédacteurs, cela devient ingérable.
La réponse a été le CMS (Content Management System, système de gestion de contenu) : un logiciel installé sur le serveur, qui range les textes dans une base de données et fabrique les pages à la volée.
Le rédacteur travaille dans une interface d'administration qui ressemble à un traitement de texte, et n'écrit jamais une balise.
WordPress, lancé le 27 mai 2003 par Matt Mullenweg et Mike Little pour tenir un blog, est devenu l'outil dominant, comme le retrace l'article Wikipédia qui lui est consacré.
Selon W3Techs, qui analyse chaque jour les dix millions de sites les plus visités du monde, WordPress fait tourner 40,3 % de tous les sites web au 14 septembre 2026, soit 58,8 % de ceux qui utilisent un CMS identifié.
Loin derrière viennent Shopify (5,4 %), Wix (4,2 %), Squarespace (2,4 %), Joomla (1,1 %), Drupal (0,6 %) et le français PrestaShop (0,5 %).
La force de WordPress est son écosystème : des milliers de thèmes (l'apparence) et d'extensions (les fonctions), gratuits ou payants, que l'on active en un clic.
Sa faiblesse en est le revers : un site WordPress doit être mis à jour et surveillé, car une extension mal entretenue est la porte d'entrée classique des piratages.
Wix et Squarespace incarnent l'autre modèle, le constructeur en ligne : on n'installe rien, on loue le service, on glisse-dépose des blocs, et l'on ne possède pas vraiment son site.
Les 31,5 % restants n'utilisent aucun CMS connu : sites codés à la main, générés par un script, ou applications sur mesure.
Ce site est dans cette catégorie : cinq pages HTML produites par un script Python à partir d'un fichier de contenu, puis copiées telles quelles sur le serveur.
Pour un marketeur, le choix du CMS est une décision de gestion avant d'être un choix technique : qui mettra le contenu à jour, à quel coût, et avec quelle dépendance à un prestataire.
La tendance no-code
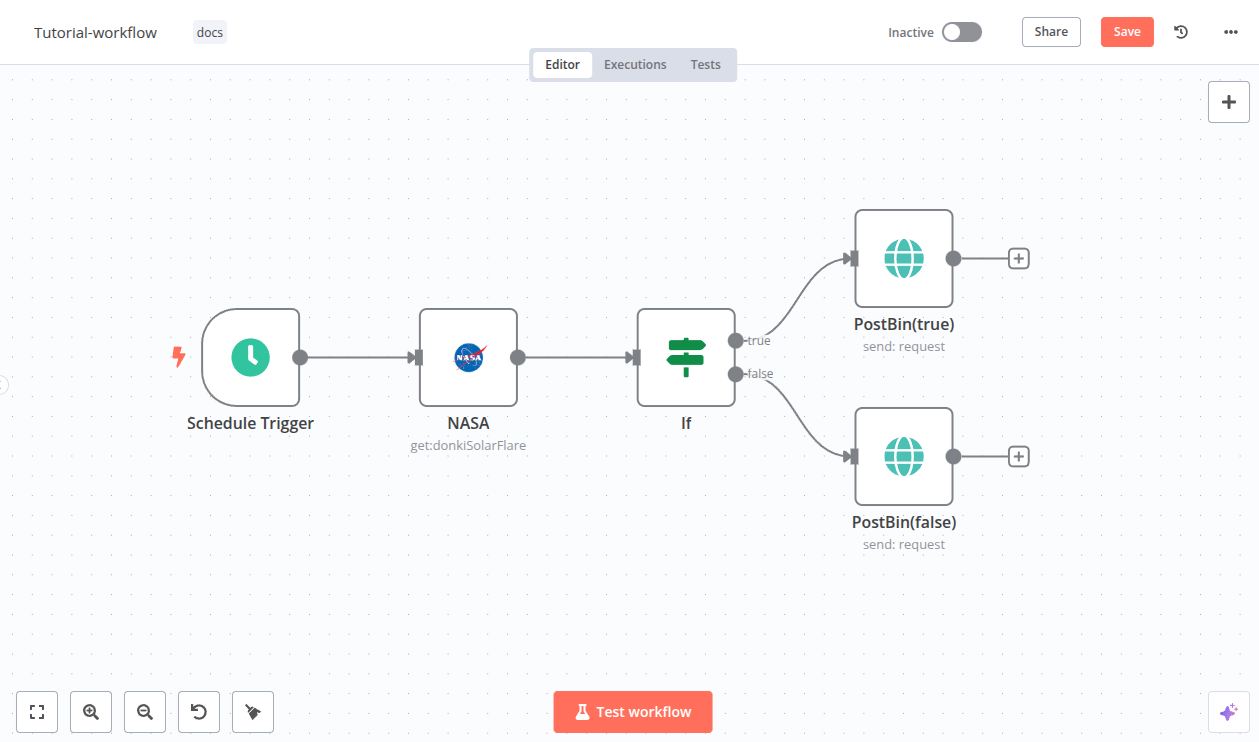
Le no-code désigne des outils qui permettent de construire un site, une application ou une automatisation en assemblant des briques toutes faites, par glisser-déposer, sans écrire une ligne de code.
L'idée prolonge les CMS vus plus haut : WordPress avait rendu le site accessible aux non-développeurs, et le terme no-code apparaît dans les années 2010 quand des plateformes étendent le principe à tout ce qui tourne derrière un site.
Pour les sites, on trouve Wix, Webflow ou WordPress équipé d'un constructeur de pages comme Elementor ; pour les bases de données et les applications, Airtable, Notion, Bubble (cofondé par un Français) et Glide.
Pour les formulaires, Tally ou Typeform ; pour la boutique en ligne, Shopify ; et pour relier tout cela, les outils d'automatisation Make, n8n et Zapier.
La capture ci-dessus montre le principe dans n8n : chaque carré est une brique (un déclencheur, un appel à un service, une condition, une action), et les flèches indiquent dans quel ordre les données circulent.
Le cabinet Gartner prévoyait en novembre 2021 que 70 % des nouvelles applications développées par les entreprises reposeraient sur du low-code ou du no-code en 2025, contre moins de 25 % en 2020, et il estimait en décembre 2022 le marché mondial de ces technologies à 26,9 milliards de dollars pour 2023, en hausse de 19,6 % sur un an.
Cette croissance tient à deux causes : les développeurs manquent et coûtent cher, et les logiciels sont passés dans le cloud avec des API (vues au chapitre sur les technologies classiques), c'est-à-dire des prises normalisées qui permettent de les brancher les uns aux autres sans programmer.
Pour un marketeur, le gain est concret : un formulaire Tally qui crée une fiche dans un CRM comme HubSpot ou Brevo, puis déclenche un e-mail de bienvenue, se monte en une heure environ dans Make sans solliciter un développeur.
Le même principe sert à publier automatiquement sur les réseaux sociaux, à prévenir l'équipe dès qu'un avis négatif tombe, ou à remplir chaque soir un tableau Airtable avec les ventes Shopify de la journée.
Première limite, la dépendance : vos données et vos automatisations vivent chez un éditeur qui peut changer ses tarifs, supprimer une fonction ou fermer, et migrer ailleurs se fait rarement en un clic.
Deuxième limite, le coût : ces outils se paient à l'usage, Make compte en « crédits »
(1 000 par mois gratuits, puis 9 $ par mois pour 10 000 en septembre 2026) et n8n en exécutions de flux (10 000 par mois pour 50 € en facturation annuelle, à la même date), si bien que la note grimpe avec le succès.
Troisième limite, le plafond de verre : dès qu'un besoin sort des briques prévues, il faut quand même du code, et les plateformes qui acceptent d'en ajouter un peu se disent « low-code ».
Le no-code assemble des briques écrites par d'autres ; l'IA générative, elle, écrit le code à partir d'une phrase, ce que l'on appelle le vibe coding, et les titres suivants de ce chapitre montrent qu'un site complet peut sortir d'un simple prompt.
Les deux approches coexistent en 2026, Make et n8n ont d'ailleurs ajouté des briques d'IA à leurs flux, et dans les deux cas la compétence qui compte pour vous est la même : savoir décrire précisément une chaîne d'actions, quel que soit l'outil qui l'exécute.
Site vitrine ou site dynamique : là où entre la base de données
| id_commande | id_client | date | produit | montant | statut |
| 10 481 | 2 207 | 2026-09-12 | Bougie vanille 220 g | 24,90 € | expédiée |
| 10 482 | 815 | 2026-09-12 | Coffret 3 bougies | 59,00 € | payée |
| 10 483 | 2 207 | 2026-09-13 | Recharge cire | 12,50 € | panier abandonné |
Un site vitrine présente une entreprise : qui l'on est, ce que l'on vend, où l'on est, comment nous joindre ; ses pages sont les mêmes pour tout le monde et changent rarement.
Techniquement, c'est un site statique : des fichiers HTML posés sur un serveur, exactement comme ce site de cours.
Un site dynamique, lui, fabrique chaque page au moment où on la demande, à partir d'informations qui changent sans cesse : un stock, un prix, un panier, un compte client.
Ce travail se fait dans la partie invisible du site, le back-end : un programme qui tourne sur le serveur et une base de données qu'il interroge, par opposition au front-end, la page que voit le visiteur.
Le tableau ci-dessus montre à quoi ressemble une table « commandes » d'une petite boutique de bougies ; une table « clients » et une table « produits » lui sont reliées par des numéros, d'où le nom de base relationnelle.
On y lit déjà du marketing : le client 2 207 a commandé deux fois en deux jours et vient d'abandonner un panier, ce qui déclenchera peut-être un e-mail de relance.
Une requête SQL se lit presque comme de l'anglais, par exemple « sélectionne les commandes de plus de 50 € passées en septembre ».
WordPress lui-même repose sur une base MySQL : chaque article, chaque commentaire y est une ligne d'une table.
Le commerce en ligne est le cas type du site dynamique : impossible de vendre sans mémoriser qui a commandé quoi, à quel prix, et si c'est payé et expédié.
Deux solutions dominent : WooCommerce, extension gratuite de WordPress lancée en septembre 2011 et rachetée en 2015 par Automattic, équipe 47,8 % des sites marchands recensés par W3Techs (14 septembre 2026).
Shopify, entreprise canadienne fondée à Ottawa en 2006, en équipe 32,1 % selon la même source, avec un modèle inverse : tout est hébergé chez eux, à partir de 27 € par mois (offre Basic en paiement annuel, septembre 2026), sans rien installer.
WooCommerce ne coûte rien à l'achat mais exige un hébergement, des mises à jour et des compétences ; Shopify coûte un abonnement mais enlève tous les soucis techniques, et prélève des frais sur chaque paiement encaissé.
Pour le marketeur, la base de données est le trésor : c'est là que dorment l'historique d'achat, les paniers abandonnés et les adresses e-mail, matière première du chapitre sur les traces digitales.
L'IA aujourd'hui : un site en deux minutes
Jusqu'en 2024, faire un site demandait soit d'apprendre les briques ci-dessus, soit de payer quelqu'un qui les connaît, avec plusieurs jours de travail pour un simple site vitrine.
Depuis, les grands modèles de langage écrivent du HTML, du CSS et du JavaScript mieux que la plupart des humains, parce qu'ils ont été entraînés sur l'essentiel du Web public et du code partagé sur GitHub.
En février 2025, Andrej Karpathy, membre fondateur d'OpenAI, a donné un nom à cette pratique : le vibe coding, décrire ce que l'on veut en langage courant et laisser l'IA produire le code.
Les outils ont suivi : Claude Code (Anthropic), Codex (OpenAI) ou Gemini CLI (Google) sont des agents qui ne se contentent pas de proposer du code : ils créent les fichiers, les testent et les corrigent eux-mêmes.
Concrètement, un prompt de quelques phrases suffit pour obtenir un site vitrine complet, en français, lisible sur téléphone, en deux minutes ; c'est ce que je vais vous montrer.
Les hébergeurs s'y sont mis aussi : Hostinger vend un constructeur de sites par IA, Hostinger AI Builder (lancé sous le nom Horizons), où l'on décrit son site dans une case de texte.
La vidéo ci-dessus montre le trajet complet, du premier prompt jusqu'à l'adresse publique, en un quart d'heure.
Ce que cela change pour vous : le coût de fabrication d'un site tend vers zéro, donc la valeur se déplace vers ce que l'IA ne décide pas à votre place, l'offre, la cible, le message, et le trafic qui viendra ou non.
Cela change aussi le rapport de force avec les agences et les freelances : un gestionnaire capable de produire un prototype en dix minutes discute autrement un devis.
Deux minutes, c'est pour un site vitrine ; une boutique avec paiement, stock et base de données reste un projet où l'IA aide beaucoup, mais où chaque erreur coûte de l'argent réel.
Et l'IA ne sait pas ce que vous voulez vendre, ni à qui : le prompt est un exercice de marketing avant d'être de l'informatique.
La démo en direct : Claude Code sur mon Mac, en local
| Étape | Ce que vous verrez à l'écran | Durée |
| 1 | Le Terminal s'ouvre, je crée un dossier vide sur le Bureau | 10 s |
| 2 | Je lance Claude Code dans ce dossier | 5 s |
| 3 | Je colle le prompt, Claude annonce les fichiers qu'il va créer | 20 s |
| 4 | Les fichiers s'écrivent sous nos yeux, Claude relit et corrige | 1 à 2 min |
| 5 | Un double-clic sur index.html, le site s'affiche dans Safari | 5 s |
Claude Code est un programme qui s'installe sur l'ordinateur et se pilote depuis le Terminal, cette fenêtre où l'on tape des commandes au lieu de cliquer.
« En local » signifie que les fichiers sont créés sur mon Mac, dans un dossier ordinaire ; seul le raisonnement de l'IA se fait sur les serveurs d'Anthropic.
L'installation, faite une fois pour toutes, tient en une ligne, donnée par la documentation officielle.
terminalcurl -fsSL https://claude.ai/install.sh | bash
J'ouvre le Terminal, je crée un dossier vide pour le projet et je m'y place.
terminalmkdir ~/Desktop/boulangerie
cd ~/Desktop/boulangerie
Je lance Claude Code dans ce dossier avec une commande d'un seul mot.
terminalclaude
Je colle ensuite le prompt suivant, que vous pourrez réutiliser tel quel en changeant le commerce.
promptCrée dans ce dossier le site vitrine d'une boulangerie artisanale de Clermont-Ferrand, « Le Fournil de Jaude ». Une seule page index.html, avec un fichier style.css et un fichier script.js séparés, sans aucune bibliothèque externe. Contenu : un bandeau avec le nom et une phrase d'accroche, une section « Nos pains » avec six produits et leurs prix, une section « Horaires et adresse », un formulaire de commande de gâteau (nom, téléphone, date, message) dont le bouton affiche un message de confirmation en JavaScript. Style chaleureux, lisible sur téléphone, textes en français. Le site doit s'ouvrir par un double-clic sur index.html et fonctionner du premier coup.
Claude Code réfléchit quelques secondes, annonce qu'il va créer trois fichiers, demande mon accord, puis les écrit sous vos yeux : index.html, style.css, script.js.
Il ne se contente pas d'écrire : il relit son code, corrige une balise oubliée, et me dit quand c'est prêt.
J'ouvre le résultat sans rien installer d'autre, depuis la même fenêtre.
terminalopen index.html
Le site s'affiche dans Safari, le navigateur par défaut du Mac, du premier coup : c'est le point important, il n'y a rien à « faire marcher », le fichier s'ouvre comme n'importe quel document.
Si quelque chose ne me plaît pas, je le dis en français dans la même fenêtre, par exemple « mets la carte des pains en trois colonnes », et il modifie le fichier.
Ceux qui voudront refaire la manipulation chez eux avec un modèle gratuit et local trouveront la marche à suivre dans le chapitre « Je vous guide », via Ollama.
La mise en ligne sur Hostinger

Un site sur mon Mac n'est visible que par moi ; pour que 300 étudiants le lisent, il faut le poser sur un serveur allumé jour et nuit, relié à Internet par une connexion solide.
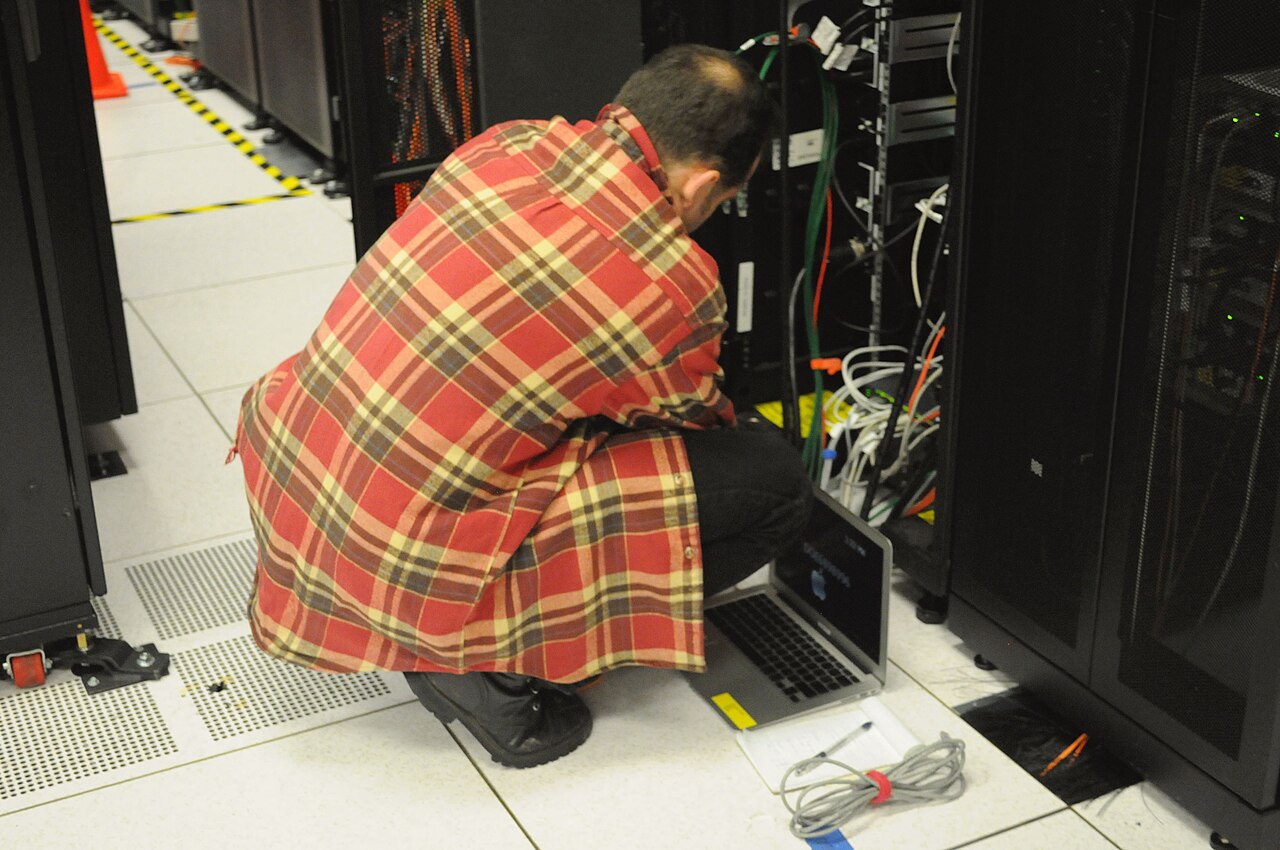
C'est le métier de l'hébergeur web : louer un morceau de machine comme celles de la photo, avec l'électricité, la sécurité et la connexion qui vont avec.
Ce site est hébergé chez Hostinger, entreprise lituanienne née en 2004, dont l'offre d'entrée est affichée 2,99 € par mois en septembre 2026 (prix promotionnel pour 48 mois payés d'avance, puis 9,99 € par mois au renouvellement), nom de domaine offert la première année et certificat HTTPS compris.
La mise en ligne tient en trois gestes, décrits dans le tutoriel de l'hébergeur : je me connecte au panneau de contrôle (hPanel), j'ouvre le Gestionnaire de fichiers, et je dépose le contenu de mon dossier site dans le répertoire public_html.
public_html est la racine : ce qui s'y trouve est ce que le monde voit, et index.html est le fichier que le serveur envoie quand on tape seulement le nom de domaine.
Il n'y a rien à compiler ni à configurer : ce sont exactement les cinq pages HTML, la feuille de style, le script et les images de mon Mac, 1,3 Mo en tout.
Quelques secondes plus tard, l'adresse répond ; quand je corrige une page, je remplace le fichier et la correction est en ligne pour le visiteur suivant.
Le nom de domaine, lui, se loue à l'année auprès d'un bureau d'enregistrement, souvent l'hébergeur lui-même, et c'est lui que le DNS traduira en adresse IP à chaque visite.
Pour un site statique comme celui-ci, il existe aussi une option gratuite, GitHub Pages, qui héberge 0,2 % des sites web selon W3Techs (14 septembre 2026), mais demande d'apprendre l'outil Git.
Pour la démo, je dépose de la même façon le dossier boulangerie créé à l'étape précédente ; entre le prompt et l'adresse publique, il se sera passé moins de dix minutes.
Une boutique WooCommerce ou un WordPress demanderait en plus une base MySQL, que Hostinger fournit aussi, mais qu'il faudrait sauvegarder et entretenir.
Retenez la chaîne complète : un prompt, un dossier de fichiers, un serveur loué, un nom de domaine ; tout le reste, le contenu, l'offre et l'audience, reste votre travail de gestionnaire.
Traces digitales et marketing
Digital = serveurs = traces numériques
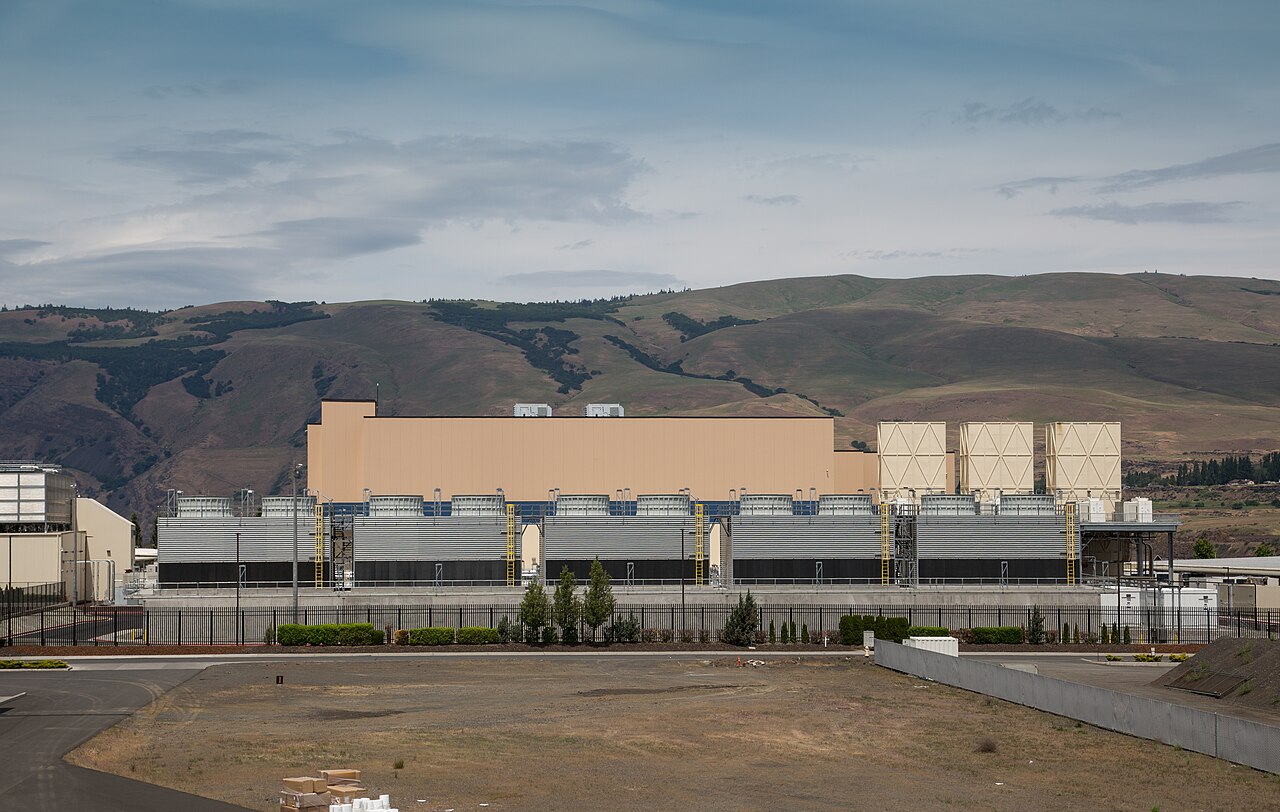

Derrière le mot « digital », il y a des machines : chaque application que vous ouvrez dialogue avec un serveur, un ordinateur allumé en permanence dans un centre de données comme celui de la photo.
Google publie la liste de ses sites en Amérique, en Europe et en Asie, et ce site de cours, plus modestement, vit sur un serveur loué chez un hébergeur.
Un serveur ne fait rien sans l'écrire : chaque requête qu'il reçoit devient une ligne dans un fichier journal, le « log ».
Voici une ligne telle que l'écrit Apache, un logiciel de serveur web qui fait tourner 22 % des sites en septembre 2026, quand un téléphone ouvre la page de cette séance depuis Google.
log serveur203.0.113.42 - - [14/Sep/2026:10:32:07 +0200] "GET /seances/cm-1.html HTTP/1.1" 200 48213 "https://www.google.com/" "Mozilla/5.0 (iPhone; CPU iPhone OS 26_0 like Mac OS X) AppleWebKit/605.1.15 (KHTML, like Gecko) Version/26.0 Mobile/15E148 Safari/604.1"
De gauche à droite : l'adresse IP du visiteur, la date et l'heure à la seconde, la page demandée, le code 200 qui signifie « servie sans erreur », la taille envoyée en octets, la page d'où il venait (ici Google) et enfin le navigateur et l'appareil, un iPhone.
Une seule visite de cette page déclenche plusieurs dizaines de lignes de ce type, une par fichier chargé : le texte, la mise en forme, chaque image.
Personne ne lit ces lignes une à une ; des programmes les comptent, les croisent avec l'heure et l'adresse IP, et en tirent des visiteurs, des parcours et des origines de trafic.
C'est ce qu'on appelle une trace numérique : une information qu'un dispositif enregistre sur l'activité ou l'identité de ses utilisateurs, parfois parce qu'ils l'ont voulu (un avis, un like), le plus souvent à leur insu (la ligne de log ci-dessus).
La trace n'est d'ailleurs pas qu'en ligne : la carte de fidélité du supermarché enregistre chaque ticket, le badge de la salle de sport note vos horaires, le compteur de passages d'un magasin compte les entrées.
Pour le marketing, ces traces sont la matière première : connaître les clients, personnaliser, cibler la publicité, fixer un prix.
C'est le fil que nous tirerons dès la séance 2 : le marketing décide avec des traces, et des traces fausses ou mal lues font de mauvaises décisions.
Les fondements du web : la gratuité en échange de la donnée
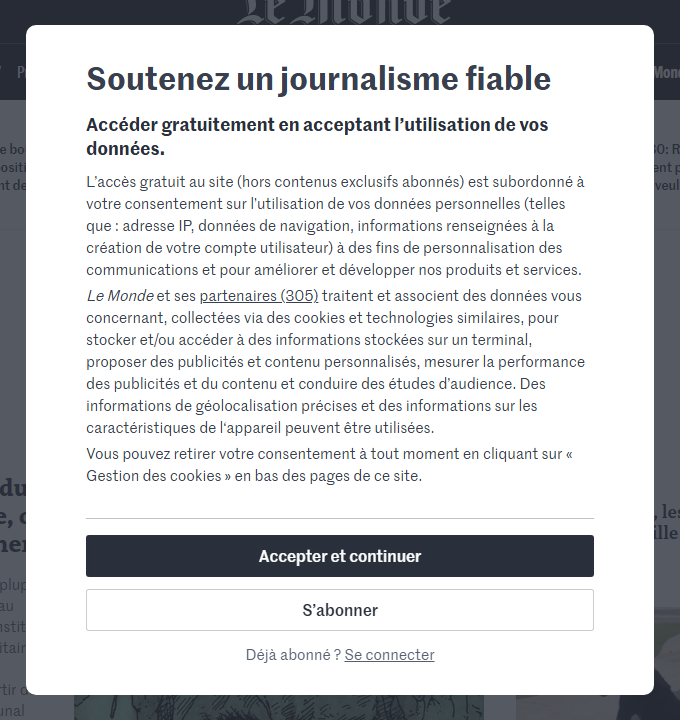
Ce message du Monde résume en une phrase le modèle économique du web : le service est gratuit, la donnée est le paiement.
Ce n'est pas une exception mais la règle : la recherche Google, YouTube, Gmail, Instagram, WhatsApp et TikTok ne vous facturent rien et vivent de la publicité.
Les chiffres sont publics parce que ces entreprises sont cotées : en 2025, Alphabet (la maison mère de Google) a encaissé 402,8 milliards de dollars de revenus, dont 294,7 milliards de publicité, soit 73 % du total.
La même année, Meta (Facebook, Instagram, WhatsApp) a déclaré 201,0 milliards de dollars de revenus, dont 196,2 milliards de publicité, soit 98 %, pour 3,58 milliards de personnes actives chaque jour en décembre 2025.
| Groupe (exercice 2025) | Revenus totaux | Dont publicité | Part de la publicité |
|---|---|---|---|
| Alphabet (Google, YouTube) | 402,8 Md$ | 294,7 Md$ | 73 % |
| Meta (Facebook, Instagram, WhatsApp) | 201,0 Md$ | 196,2 Md$ | 98 % |
Ce que l'annonceur achète n'est pas un espace comme une page de magazine, c'est une audience qualifiée : montrer une chaussure de trail à quelqu'un qui a cherché « trail Sancy » la veille.
La donnée est précisément ce qui rend l'audience qualifiée, d'où l'intérêt vital des plateformes à en collecter le plus possible, le plus longtemps possible.
La CNIL le formule sobrement dans son avis du 16 mai 2022 sur les murs de traceurs : la gratuité pécuniaire n'est pas sans contrepartie, les données collectées financent le service par la publicité ciblée.
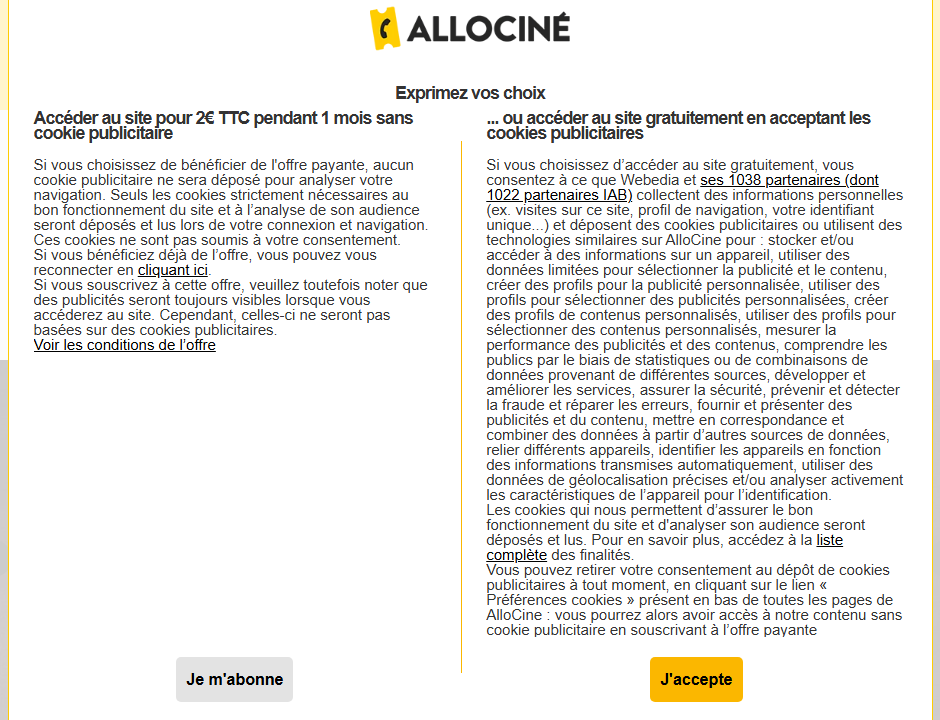
Les formules « accepter ou payer » du Monde ou d'Allociné ont un mérite pédagogique : elles affichent le prix implicite de vos traces pour un site, deux euros par mois chez Allociné en septembre 2026.
Pour un futur marketeur, ce modèle explique pourquoi une campagne Google ou Meta se paie au clic ou à l'affichage, et pourquoi ces plateformes connaissent mieux vos clients que votre propre entreprise.
Il explique aussi la nervosité du secteur dès qu'un navigateur, un téléphone ou une loi restreint la collecte : c'est le chiffre d'affaires qui est touché, comme on le verra avec Apple au titre sur les autres façons de surveiller.
Le cookie
Un cookie est un petit fichier texte qu'un site demande à votre navigateur de conserver, puis de lui renvoyer à chaque nouvelle visite.
Il a été inventé en juin 1994 chez Netscape par Lou Montulli pour un besoin banal : qu'un site de vente se souvienne de votre panier d'une page à l'autre.
Un cookie de première partie est déposé par le site dont le nom est dans la barre d'adresse : il garde votre panier, votre langue, votre session connectée.
Un cookie tiers est déposé par un autre domaine présent dans la page, une régie publicitaire, un bouton de partage ou un outil de mesure, et comme ce domaine est présent sur des milliers de sites, il vous reconnaît de l'un à l'autre (voir les définitions de la CNIL).
C'est le cookie tiers qui permet le reciblage, cette paire de baskets regardée une fois et qui vous suit ensuite sur les sites de presse.
La bannière que vous cliquez partout vient de là : depuis ses lignes directrices du 29 septembre 2020, la CNIL exige un consentement avant tout traceur non indispensable, et que refuser soit aussi aisé qu'accepter ; le chapitre « Cadre légal » y revient.
Les 1 038 partenaires d'Allociné sont autant de domaines tiers qui peuvent recevoir une part de vos traces si vous cliquez « J'accepte ».
Le cookie tiers est pourtant en sursis depuis longtemps : Firefox bloque par défaut les cookies tiers de pistage depuis le 3 septembre 2019 et Safari bloque tous les cookies tiers depuis le 24 mars 2020.
Google a annoncé le 14 janvier 2020 leur disparition de Chrome « d'ici deux ans », puis a repoussé l'échéance à fin 2023 en juin 2021, au second semestre 2024 en juillet 2022, puis une troisième fois à 2025.
Le 22 juillet 2024, Google renonce à la suppression et promet à la place une nouvelle invite qui laisserait le choix à l'utilisateur ; le 22 avril 2025, il renonce aussi à cette invite et laisse les cookies tiers tels quels, réglables dans les paramètres ; le 17 octobre 2025, il abandonne la plupart des technologies de remplacement qu'il avait conçues.
La raison est économique : Chrome appartient au premier vendeur de publicité au monde, et le régulateur britannique de la concurrence a encadré le projet de bout en bout, soupçonné de renforcer Google face aux autres acteurs de la publicité en ligne.
Pour un marketeur en 2026, la conséquence est concrète : le cookie tiers fonctionne encore sur Chrome, plus sur Safari ni Firefox, donc une partie de l'audience échappe au reciblage, et les marques investissent dans la donnée qu'elles collectent elles-mêmes, comptes clients et CRM.
Les autres façons de surveiller
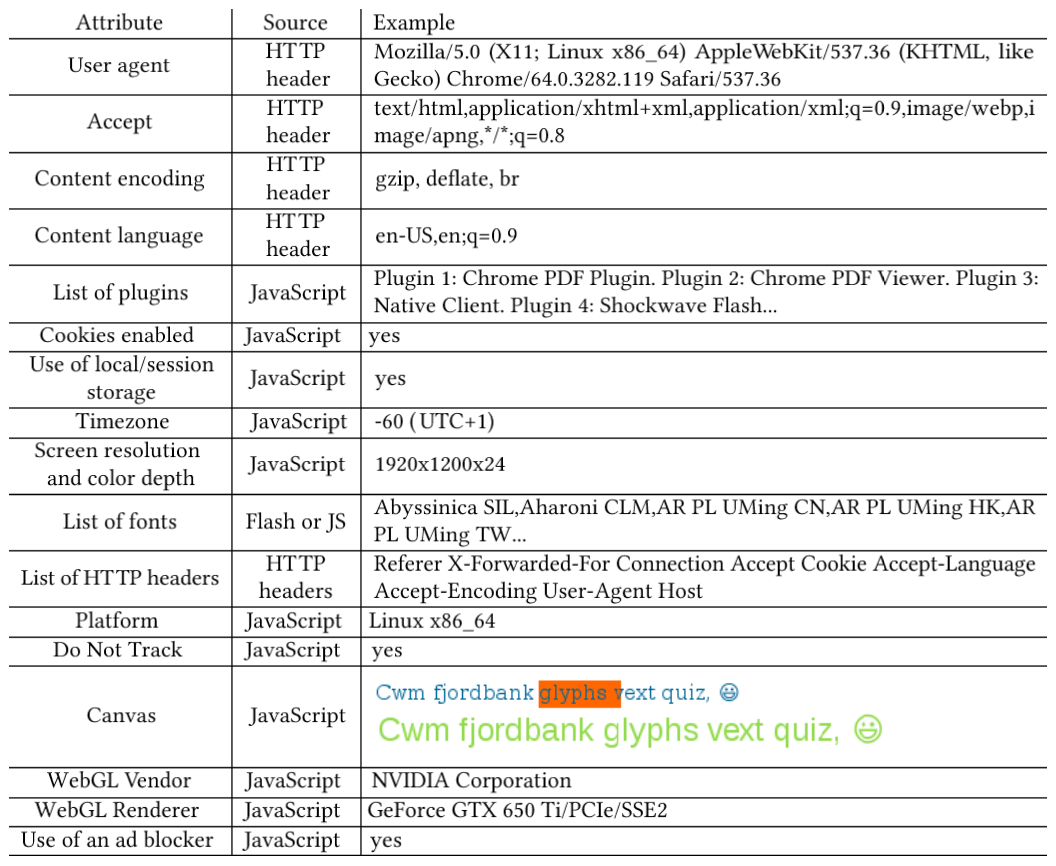

Refuser les cookies ne vous rend pas invisible : quatre autres techniques prennent le relais.
La première est l'empreinte du navigateur, que la CNIL définit comme une technique probabiliste qui identifie un utilisateur à partir des caractéristiques techniques de son navigateur : taille d'écran, polices installées, fuseau horaire, carte graphique, langue.
Prise une à une, chaque caractéristique est banale ; combinées, elles forment une signature souvent unique, sans rien déposer sur votre appareil, donc sans bannière à cliquer.
Vous pouvez tester la vôtre sur Am I Unique, un site de recherche hébergé par l'Inria, ou sur Cover Your Tracks de l'Electronic Frontier Foundation.
La deuxième est le pixel de suivi : une image invisible d'un pixel, chargée depuis le serveur de l'annonceur, dont le simple chargement écrit une ligne de log, exactement comme au premier titre.
Le pixel Meta en est la version industrielle : un bout de code placé sur un site marchand, qui signale à Meta les pages vues, les ajouts au panier et les achats, pour mesurer les campagnes et fabriquer des audiences.
Le même pixel, glissé dans un courriel, dit à l'expéditeur si vous avez ouvert le message, quand et depuis quel appareil.
La troisième est l'identifiant publicitaire mobile : chaque téléphone porte un numéro unique réservé à la publicité, l'IDFA chez Apple et l'Advertising ID chez Google, partagé par toutes les applications installées.
Depuis iOS 14.5, sorti en avril 2021, chaque application doit demander la permission de s'en servir, et dès mai 2021 le cabinet Flurry mesurait que 96 % des utilisateurs américains refusaient.
Meta a chiffré la perte à 10 milliards de dollars pour la seule année 2022.
La quatrième est la plus puissante : la connexion à un compte, car une fois identifié chez Google ou Meta, tout ce que vous faites est rattaché à votre nom, sur tous vos appareils, sans cookie ni empreinte.
Ouvrez Mon activité Google avec votre compte : recherches, vidéos, lieux, tout y est daté, et le bouton « Se connecter avec Google » sur un site tiers étend cette reconnaissance hors de Google.
Un marketeur distingue ainsi la trace déterministe, fondée sur un compte, et la trace probabiliste, fondée sur une empreinte : la première vaut plus cher parce qu'elle se trompe moins.
Les API
| Plateforme et API | Ce que l'annonceur envoie | Ce que l'annonceur reçoit |
|---|---|---|
| Meta Marketing API | Campagnes, budgets, visuels, critères d'audience (âge, lieu, centres d'intérêt), listes de clients | Impressions, clics, coûts, conversions par audience, jamais les profils individuels |
| Meta Conversions API | Les achats et inscriptions constatés sur son propre serveur (adresse courriel hachée, montant) | L'attribution : quelle publicité a précédé quel achat |
| Google Ads API | Mots-clés, enchères, annonces, audiences | Rapports de performance par mot-clé, appareil, heure, zone |
| Google Analytics Data API | Rien : c'est la mesure de son propre site | Visites, pages, sources de trafic, parcours, agrégés par Google |
| Reddit Data API (payante depuis 2023) | De l'argent | Les messages publics, pour l'analyse ou l'entraînement d'IA |
Une API est une porte réservée aux programmes : un logiciel interroge un autre logiciel sans passer par l'écran, et le chapitre sur les technologies classiques en décrit le mécanisme.
Ce qui nous intéresse ici, c'est ce que les plateformes laissent passer par cette porte, dans les deux sens.
Elles ne vendent jamais vos données brutes : elles vendent un accès à des audiences, et l'API est le guichet où l'annonceur passe commande.
Avec la Marketing API de Meta, une agence crée des centaines de campagnes par programme, cible « les 18-25 ans de Clermont-Ferrand intéressés par la randonnée » ou des personnes « similaires » à ses meilleurs clients, puis lit les résultats.
La Conversions API va dans l'autre sens : le marchand envoie à Meta, depuis son serveur, les achats réalisés, avec une adresse courriel hachée, pour que Meta rattache l'achat à la publicité vue même quand le navigateur bloque les cookies.
Google offre la même paire de guichets, Google Ads pour acheter et Google Analytics pour mesurer son propre site.
La règle du jeu est constante : l'annonceur donne ses données clients et reçoit des agrégats, la plateforme garde les profils.
Quand cette règle a été mal réglée, cela a donné le scandale Cambridge Analytica : jusqu'en 2015, l'API de Facebook permettait à une application de test de personnalité, installée par 270 000 personnes, de lire aussi les données de leurs amis, soit jusqu'à 87 millions de profils au total.
Depuis, l'accès aux données individuelles s'est refermé et monétisé : Reddit a rendu son API payante en 2023, au point que l'application Apollo aurait dû verser 20 millions de dollars par an, et a préféré fermer.
Pour un marketeur, connaître l'API d'une plateforme, c'est connaître exactement ce qu'on peut y mesurer ; tout le reste est une boîte noire, et c'est pour cela que les séances suivantes parleront de tests et d'expérimentation plutôt que de confiance.
Des exemples de métiers du marketing digital
Ces traces font vivre des métiers, et chacun d'eux se définit par ce qu'il fait des traces.
Le traffic manager (fiche France Travail) achète du trafic sur Google Ads, Meta Ads ou par affiliation, puis lit les sources de visite et les conversions pour savoir quel euro dépensé a rapporté quoi.
Sa trace de prédilection est la page d'origine et les paramètres ajoutés aux liens, qui disent d'où vient chaque visiteur ; France Travail comptait 550 offres pour ce métier sur les douze mois précédant le premier trimestre 2026.
Le chargé de référencement (fiche France Travail) travaille le SEO, être trouvé gratuitement dans Google, et le SEA, payer pour apparaître sur des mots-clés.
Ses traces sont les requêtes tapées par les internautes, qu'il lit dans la Search Console, et les positions et clics qui en découlent.
Le gestionnaire CRM tient la base clients : achats, courriels ouverts, paniers abandonnés, avec des outils comme HubSpot ou Brevo, et c'est le métier qui monte avec le recul du cookie tiers, parce que ses traces sont de première partie.
Le data analyst transforme les journaux et les bases en tableaux de bord et en modèles, segmentation ou prédiction, avec SQL et Python ; sa variante centrée sur le site est le web analyst, qui définit ce qu'on mesure et lit les parcours dans Google Analytics ou Matomo.
Le growth n'a pas de fiche Apec, mais des offres : en start-up, il teste vite des leviers, parrainage, inscription, tarifs, et ne garde que ce que les traces valident.
Le point commun est visible : aucun n'écrit le code du serveur, tous lisent des traces et prennent des décisions, et c'est exactement ce que ce cours cherche à vous apprendre.
Côté salaires, les fiches de l'Apec consultées en septembre 2026 donnent des fourchettes de 30 à 65 k€ bruts annuels selon le métier, avec des moyennes de 39 k€ pour le référencement à 47 k€ pour le CRM.
Ces métiers sont ceux que prépare, à l'IAE, le master Marketing Opérationnel et Digital ; en L2, il suffit de savoir qu'ils existent et qu'ils vivent tous de la même matière première.
L'enjeu du moment : l'IA
Qu'est-ce qu'une IA ?
L'intelligence artificielle désigne, au sens large, tout programme qui accomplit une tâche que l'on croyait réservée à l'intelligence humaine : reconnaître un visage, traduire, jouer aux échecs, écrire.
Le terme date de 1956, quand une poignée de chercheurs réunis à la conférence de Dartmouth l'ont choisi pour nommer leur programme de recherche.
Pendant cinquante ans, on a surtout écrit des règles à la main, et les résultats sont restés décevants hors de quelques domaines fermés.
L'apprentissage automatique (machine learning) renverse la méthode : au lieu de dicter les règles, on montre des millions d'exemples à un programme qui ajuste lui-même ses réglages internes.
Le tournant a lieu en 2012, quand AlexNet, un réseau de neurones profond entraîné sur des cartes graphiques Nvidia, écrase ses concurrents au concours de reconnaissance d'images ImageNet.
En 2017, des chercheurs de Google publient l'architecture Transformer, qui permet d'entraîner des modèles bien plus grands sur du texte.
Un grand modèle de langage (LLM) est un Transformer entraîné sur une part énorme du Web pour prédire le mot suivant ; à force, il apprend la grammaire, les faits courants et le style.
L'IA générative regroupe ces modèles qui produisent du texte, des images, du son ou du code, par opposition aux IA qui se contentent de classer ou de prédire.
Le 30 novembre 2022, OpenAI met un LLM derrière une simple boîte de dialogue, ChatGPT, qui atteint 100 millions de comptes en deux mois.
Pour un gestionnaire, la distinction utile est celle-ci : une IA « classique » prédit (ce client va-t-il partir ?), une IA générative produit (écris-moi l'e-mail qui le retient).
Le chapitre suivant renvoie au cours de Vincent Barra pour la mécanique ; ici, retenez la frise et les quatre mots : IA, apprentissage automatique, IA générative, LLM.
Petit, moyen, géant : le nombre de paramètres et la fenêtre de contexte
Un grand modèle de langage se résume à une liste de nombres, les paramètres, ajustés pendant l'entraînement puis figés : ce sont les « réglages internes » du titre précédent, et leur nombre est la première chose qu'on lit sur la fiche d'un modèle.
Le nom porte souvent ce chiffre : gpt-oss-120b signifie 120 milliards de paramètres (b pour billion, milliard en anglais), pas 120 gigaoctets, même si les deux sont liés.
La règle de conversion est simple : un paramètre occupe deux octets en précision 16 bits, un demi-octet une fois compressé en 4 bits, donc un modèle de 117 milliards de paramètres pèse environ 60 gigaoctets compressé et tient sur une seule carte H100 de 80 gigaoctets, selon sa fiche Hugging Face.
Tout en bas de l'échelle, Google a publié en août 2025 Gemma 3 270M, 270 millions de paramètres, qui tourne sur un téléphone ; c'est l'esprit des versions « Flash », « mini », « nano » ou « Haiku » des grandes familles, petites, rapides et presque gratuites, pour les tâches simples et répétitives.
Au milieu, gpt-oss-20b, 21 milliards de paramètres, tient dans 16 gigaoctets de mémoire, c'est-à-dire dans un portable récent : c'est la taille des modèles que vous ferez tourner en local au chapitre « Je vous guide ».
Tout en haut, en septembre 2026, le plus gros modèle dont les poids sont publics est Kimi K3 du chinois Moonshot, 2 800 milliards de paramètres, sorti en juillet 2026, devant DeepSeek V4-Pro et ses 1 600 milliards.
Pour les modèles privés, GPT-5, Claude ou Gemini, les éditeurs ne publient pas le chiffre ; les estimations circulent mais aucune n'est confirmée, et il faut se méfier de ceux qui l'affirment.
Ces géants n'utilisent pas tous leurs paramètres à chaque mot : Kimi K3 n'en active que 104 milliards sur 2 800, grâce à l'architecture en mélange d'experts que détaille un titre plus loin, ce qui rend le calcul abordable alors que la mémoire, elle, doit contenir l'ensemble.
Plus de paramètres, c'est plus de connaissances mémorisées et plus de finesse, mais aussi plus de mémoire, plus d'électricité et plus de latence, d'où l'existence de toute cette gamme de tailles.
Ce que le modèle sait par ses paramètres s'arrête à la date de fin de son entraînement ; tout le reste, il doit le lire au moment de la requête, dans ce qu'on appelle la fenêtre de contexte.
La fenêtre de contexte, c'est tout ce que le modèle a sous les yeux quand il répond : les consignes de l'éditeur, les documents que vous joignez, la conversation depuis le début, votre question, et sa propre réponse au fur et à mesure qu'il l'écrit.
Elle se mesure en tokens, des morceaux de mots d'environ trois ou quatre caractères en français ; en 2026, Claude, Gemini et Kimi K3 acceptent un million de tokens, de quoi joindre plusieurs livres ou un dossier entier d'une seule fois.
La documentation d'Anthropic prévient cependant que plus de contexte n'est pas automatiquement mieux : la précision baisse quand la fenêtre se remplit, et choisir ce qu'on y met compte autant que la place disponible.
C'est la règle pratique à retenir pour tout ce cours : ce qui n'est ni dans les paramètres, ni dans la fenêtre, le modèle ne le sait pas, et quand il répond quand même, c'est le titre « Pourquoi elle se trompe avec aplomb » qui s'applique.
La guerre entre open source et GAFAM depuis 2022
| Date | Acteur | Fait |
|---|---|---|
| 30 nov. 2022 | OpenAI | ChatGPT : modèle fermé, accessible seulement en ligne |
| 24 févr. 2023 | Meta | LLaMA : poids diffusés aux chercheurs, fuite publique en mars |
| 18 juil. 2023 | Meta | Llama 2 : usage commercial autorisé |
| 27 sept. 2023 | Mistral AI (Paris) | Mistral 7B sous licence libre Apache 2.0 |
| 20 janv. 2025 | DeepSeek (Hangzhou) | R1 : poids ouverts, au niveau des meilleurs modèles américains |
| 5 août 2025 | OpenAI | gpt-oss : premiers modèles à poids ouverts d'OpenAI depuis 2019 |
| avril 2026 | Meta | Muse Spark succède à Llama, sans poids ouverts au lancement |
| 24 avril 2026 | DeepSeek | V4 sous licence MIT, un million de mots de contexte |
| 10 août 2026 | Meta | Muse Glimmer, petit modèle à poids ouverts |
Depuis ChatGPT, deux camps s'affrontent sur une question simple : faut-il publier les « poids » du modèle, c'est-à-dire le fichier que n'importe qui peut télécharger et faire tourner ?
OpenAI, Google (Gemini) et Anthropic (Claude) gardent leurs meilleurs modèles fermés : on y accède par un site ou une API, contre abonnement ou paiement à l'usage.
Meta a pris le contre-pied en février 2023 en diffusant LLaMA, d'abord aux chercheurs, puis à tous avec Llama 2 en juillet 2023.
Le pari de Meta était économique : si le modèle devient un bien commun, la valeur se déplace vers les services qui l'utilisent, où Meta est fort, et OpenAI perd son avance.
Mistral AI, fondée à Paris en avril 2023 par trois anciens de Meta et de DeepMind, publie Mistral 7B sous licence Apache 2.0 le 27 septembre 2023 et devient le champion européen de l'ouverture.
Attention au mot : « open source » au sens strict suppose une licence libre, or Llama impose des conditions d'usage ; on parle plus justement de modèles à poids ouverts.
Le choc vient de Chine le 20 janvier 2025 : DeepSeek publie R1, un modèle à poids ouverts au niveau des meilleurs modèles américains, entraîné pour une fraction de leur coût.
Une semaine plus tard, l'application DeepSeek est la plus téléchargée aux États-Unis et l'action Nvidia perd 17 % en une séance.
En août 2025, OpenAI cède à son tour et publie gpt-oss, ses premiers modèles à poids ouverts depuis 2019.
Le camp ouvert a pourtant vacillé en 2026 : Meta a lancé en avril Muse Spark, successeur de Llama aux poids fermés, avant de promettre une version ouverte et de publier un petit modèle ouvert, Muse Glimmer, le 10 août 2026.
Pour vous, la conséquence est concrète : un modèle à poids ouverts se télécharge et tourne sur votre ordinateur avec Ollama, sans compte ni abonnement, ce que nous ferons plus loin dans cette séance.
Nvidia, grand vainqueur de la bulle de l'IA
Entraîner et faire tourner un LLM demande des milliers de cartes graphiques (GPU), et Nvidia en fabrique l'essentiel.
Ses puces ont d'abord servi aux jeux vidéo ; AlexNet a montré en 2012 qu'elles calculaient aussi très bien les réseaux de neurones, et toute la recherche a suivi.
Le graphique montre l'action : environ 12 dollars fin septembre 2022, 218 dollars à la clôture du 11 septembre 2026, soit dix-huit fois plus en quatre ans (Yahoo Finance).
La capitalisation boursière a franchi 1 000 milliards de dollars en mai 2023, 4 000 milliards le 10 juillet 2025 et 5 000 milliards le 29 octobre 2025, une première mondiale (Wikipédia).
Au 14 septembre 2026, elle s'établit à 5 100 milliards de dollars selon CompaniesMarketCap, devant Apple (4 900 milliards), Alphabet (4 200) et Microsoft (3 800).
Le mot « bulle » circule parce que cette valeur repose sur une hypothèse : que les acheteurs de puces, Microsoft, Google, Meta, Amazon, OpenAI, continueront à dépenser des centaines de milliards par an.
Le 27 janvier 2025, quand DeepSeek a laissé penser qu'on pouvait faire aussi bien avec moins de puces, Nvidia a perdu près de 600 milliards de dollars de capitalisation en une journée, un record pour une entreprise américaine.
L'action a ensuite presque doublé, signe que le marché a conclu que l'on utiliserait encore plus de puces, pas moins.
Nvidia ne vend pas que des puces : son logiciel CUDA, avec lequel les chercheurs programment depuis quinze ans, rend le passage à un concurrent coûteux ; c'est un exemple de coût de changement que vous reverrez en marketing.
L'exercice utile est celui du cours : ouvrir le lien Yahoo Finance, regarder le cours du jour et se demander si le graphique dit encore la même chose.
USA, Chine, Europe : trois vitesses
Le AI Index de l'université Stanford, publié chaque printemps, est la source de référence pour comparer les pays.
En 2024, l'investissement privé dans l'IA atteignait 109 milliards de dollars aux États-Unis, 9 milliards en Chine et 4,5 au Royaume-Uni ; la France était sixième avec 2,6 milliards (AI Index 2025).
Additionnée, l'Europe pesait 19 milliards cette année-là, soit deux fois la Chine mais six fois moins que les États-Unis (même rapport, figure 4.3.10).
L'écart s'est encore creusé en 2025 : 286 milliards aux États-Unis contre 12 en Chine, soit vingt-trois fois plus, selon l'édition 2026.
Le même rapport nuance : la Chine finance aussi son IA par des fonds publics « d'orientation », estimés à 184 milliards de dollars entre 2000 et 2023, que ces chiffres ne comptent pas.
Côté modèles marquants, les États-Unis en ont produit 59 en 2025 contre 35 pour la Chine (AI Index 2026) ; en 2024, l'Europe entière n'en comptait que 3, tous français.
La Chine a choisi l'arme des poids ouverts : DeepSeek et Qwen, la famille de modèles d'Alibaba, sont diffusés gratuitement et adoptés dans le monde entier, ce qui compense en partie le retard d'investissement.
Sur la performance pure, le AI Index 2026 constate que l'écart entre les meilleurs modèles américains et chinois s'est refermé : en mars 2026, le meilleur modèle d'Anthropic ne devançait le meilleur chinois que de 2,7 %.
L'Europe, elle, joue la carte de Mistral, valorisée 11,7 milliards d'euros en septembre 2025 puis 21 milliards en septembre 2026 avec l'entrée de Samsung au capital, et celle de la régulation, sujet du chapitre « Cadre légal ».
Pour un futur décideur, ces trois vitesses ne sont pas anecdotiques : elles déterminent qui fixe les prix, qui détient vos données et à quelle loi votre fournisseur obéit.
Le rapport note enfin que l'adoption par les entreprises a le plus progressé en Chine et en Europe en 2025 : le retard d'investissement n'empêche pas l'usage.
Pourquoi elle se trompe avec aplomb : l'hallucination
Une hallucination est une réponse fausse mais fluide, produite avec la même assurance qu'une réponse juste.
Elle n'est pas un bug que l'on corrigera un jour : elle découle du principe même du modèle, qui choisit le mot le plus probable et non le mot vrai.
Le modèle n'a pas de base de faits où vérifier ; il a des régularités statistiques, et une question plausible appelle une réponse plausible.
L'image ci-dessus le montre : sommé de dire si Harry Potter fait équipe avec un brocoli ou une carotte, le modèle invente Brocilus le brocoli magicien au lieu de répondre que ce livre n'existe pas.
L'exemple le plus célèbre est judiciaire : en mai 2023, un cabinet d'avocats new-yorkais a remis au juge un mémoire citant six décisions de justice générées par ChatGPT, qui n'avaient jamais existé (Wikipédia).
Les modèles de 2026 hallucinent moins que ceux de 2023, notamment parce qu'ils peuvent chercher sur le Web avant de répondre, mais ils hallucinent encore, surtout sur les chiffres, les dates, les citations et les noms peu connus.
Le cas typique en gestion : demandez le chiffre d'affaires d'une PME clermontoise, vous obtiendrez un nombre précis, crédible et souvent faux.
Trois réflexes suffisent : demander la source, ouvrir la source, et se méfier d'autant plus que la réponse est précise sur un sujet obscur.
Vous pouvez tester dès maintenant avec le prompt ci-dessous, en remplaçant le nom par une entreprise que vous connaissez, puis en ouvrant le lien qu'on vous donne.
promptQuel était le chiffre d'affaires 2024 des Laboratoires Théa (Clermont-Ferrand) ? Donne un chiffre précis, la source exacte (adresse web) et la date de publication.L'activité de fin de séance vous fait justement prendre l'IA en défaut sur une donnée vérifiable, et c'est ce réflexe que l'on cherche à installer.
Retenez la règle du cours : l'IA rédige, vous vérifiez ; un chiffre sans source n'est pas un chiffre.
Un secteur en constante évolution : RAG, mixture of experts, MCP, agents
| Depuis | Brique | Ce que c'est | À quoi ça sert |
|---|---|---|---|
| 2020 | RAG | Le modèle va chercher des documents avant de répondre | Répondre à partir de vos données, à jour, en citant la source |
| 2023 | Mixture of experts | Un modèle fait de sous-réseaux spécialisés, dont quelques-uns s'activent à chaque mot | Une qualité égale pour un coût de calcul bien moindre |
| 2024 | MCP | Une prise standard entre un modèle et un outil (base de données, agenda, site) | Faire agir l'IA dans vos logiciels sans connecteur sur mesure |
| 2025 | Agents | Un modèle dans une boucle : objectif, plan, outils, vérification | Confier une tâche entière, pas une question |
En quatre ans, la manière de construire les systèmes d'IA a changé quatre fois, et chaque étape répond à une faiblesse de la précédente.
Le RAG (retrieval-augmented generation, « génération à enrichissement contextuel », décrit en 2020 par Lewis et ses collègues chez Meta) consiste à aller chercher des documents pertinents, vos contrats, votre catalogue, avant de laisser le modèle rédiger.
Il sert à répondre à partir de vos données à vous, à jour, et à citer d'où vient la réponse, ce qui réduit les hallucinations.
Le mélange d'experts (mixture of experts) est une façon de construire le modèle lui-même : au lieu d'un seul bloc géant, on assemble des sous-réseaux spécialisés et seuls quelques-uns s'activent pour chaque mot.
Mixtral 8x7B, publié par Mistral le 11 décembre 2023, a popularisé l'idée et DeepSeek l'a poussée à l'extrême ; le résultat est un modèle moins coûteux à faire tourner pour une qualité égale.
Le MCP (Model Context Protocol), publié par Anthropic le 25 novembre 2024 puis adopté par OpenAI et Google en 2025, est une prise standard qui permet à un modèle de se brancher sur un outil : une base de données, un agenda, un site web, votre boutique.
Il sert à faire faire des choses à l'IA au lieu de seulement lui parler, sans réécrire un connecteur pour chaque outil.
L'agent, enfin, est un modèle placé dans une boucle : il reçoit un objectif, planifie, utilise ses outils, vérifie le résultat et recommence jusqu'à ce que ce soit fait.
Chacune de ces briques est arrivée en dix-huit mois environ, et la suivante est probablement déjà en préparation : ce que vous apprenez ici, c'est moins un outil qu'une capacité à suivre.
L'ordre importe pour décoder les offres commerciales : quand un éditeur vous vend « une IA connectée à vos données », c'est du RAG ; « une IA qui agit dans vos logiciels », c'est du MCP et des agents.
Sous le capot : des puces et de la géopolitique
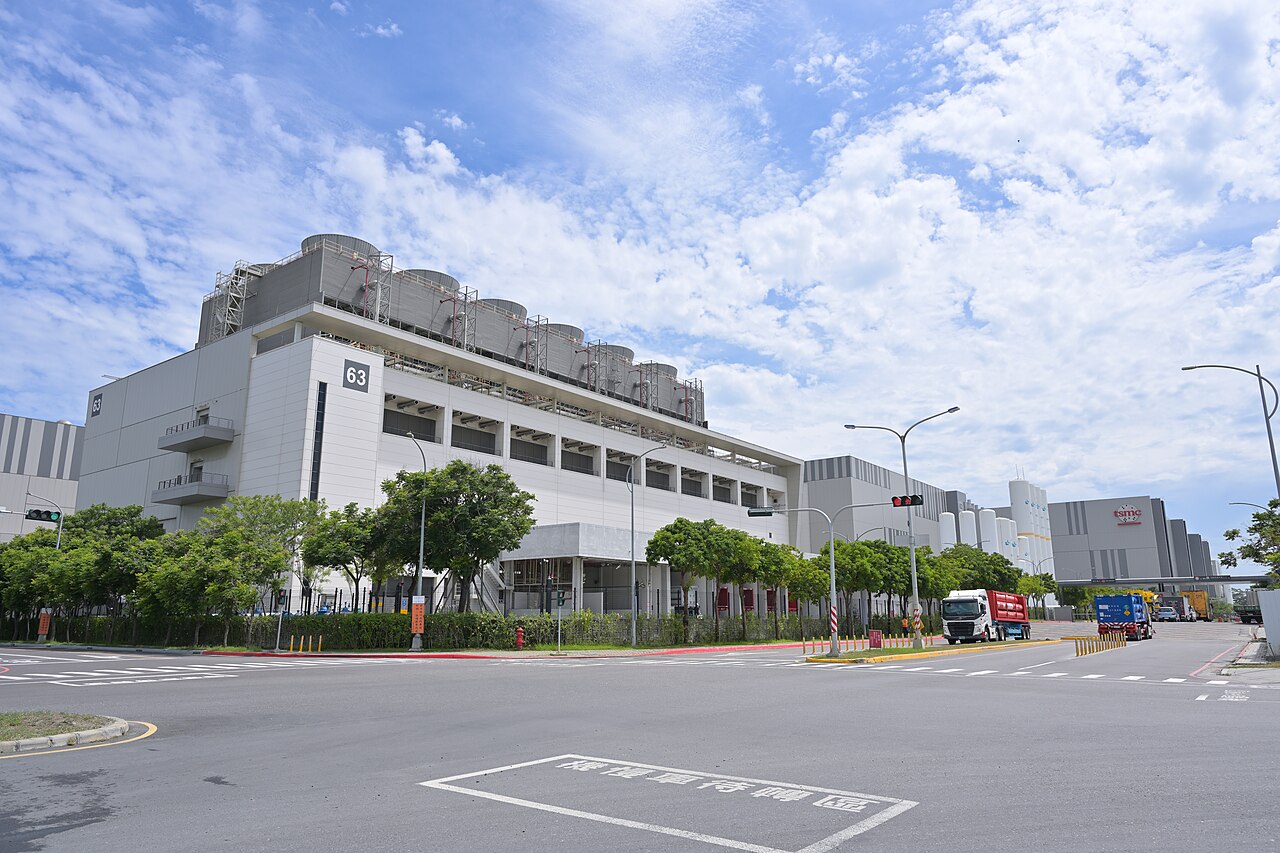
Nvidia conçoit ses puces mais ne les fabrique pas : elles sont gravées à Taïwan par TSMC, la première fonderie mondiale, qui assure plus des deux tiers de la production mondiale de puces sous-traitées (LeMagIT, juillet 2025).
Le AI Index 2026 le dit sans détour : presque toutes les puces d'IA de pointe sortent de cette seule entreprise, sur une île que la Chine considère comme une province à réunifier.
Une usine de puces de dernière génération coûte quinze milliards de dollars ou plus et prend des années à construire (IEEE Spectrum, février 2026, à propos des usines de mémoire) ; on ne déplace pas cette industrie en un mandat présidentiel.
Les États-Unis l'ont compris : depuis le 7 octobre 2022, ils interdisent l'exportation vers la Chine des puces d'IA les plus avancées et des machines qui servent à les fabriquer.
Les règles ont été durcies en octobre 2023, puis assouplies au cas par cas en 2025 et 2026, quand Washington a autorisé sous conditions la vente des puces H20 puis H200 à la Chine ; Pékin a répliqué en septembre 2025 en ordonnant à ses grandes entreprises de ne plus acheter de puces Nvidia (Wikipédia).
La Chine réagit en développant ses propres puces : DeepSeek V4, sorti en 2026, a été adopté par les fabricants chinois Huawei et Cambricon.
TSMC construit des usines en Arizona, dont la première a démarré en 2025, mais la dépendance à Taïwan restera la règle jusqu'à la fin de la décennie.
Pour un marketeur, cela veut dire qu'une IA « dans le cloud » repose sur une chaîne physique de quelques usines, et que son prix et sa disponibilité dépendent de décisions prises à Washington, Pékin et Taipei.
C'est aussi pourquoi les États parlent désormais de « souveraineté de l'IA », un thème que le AI Index 2026 place parmi ses dix constats de l'année.
L'actu : la crise de la mémoire
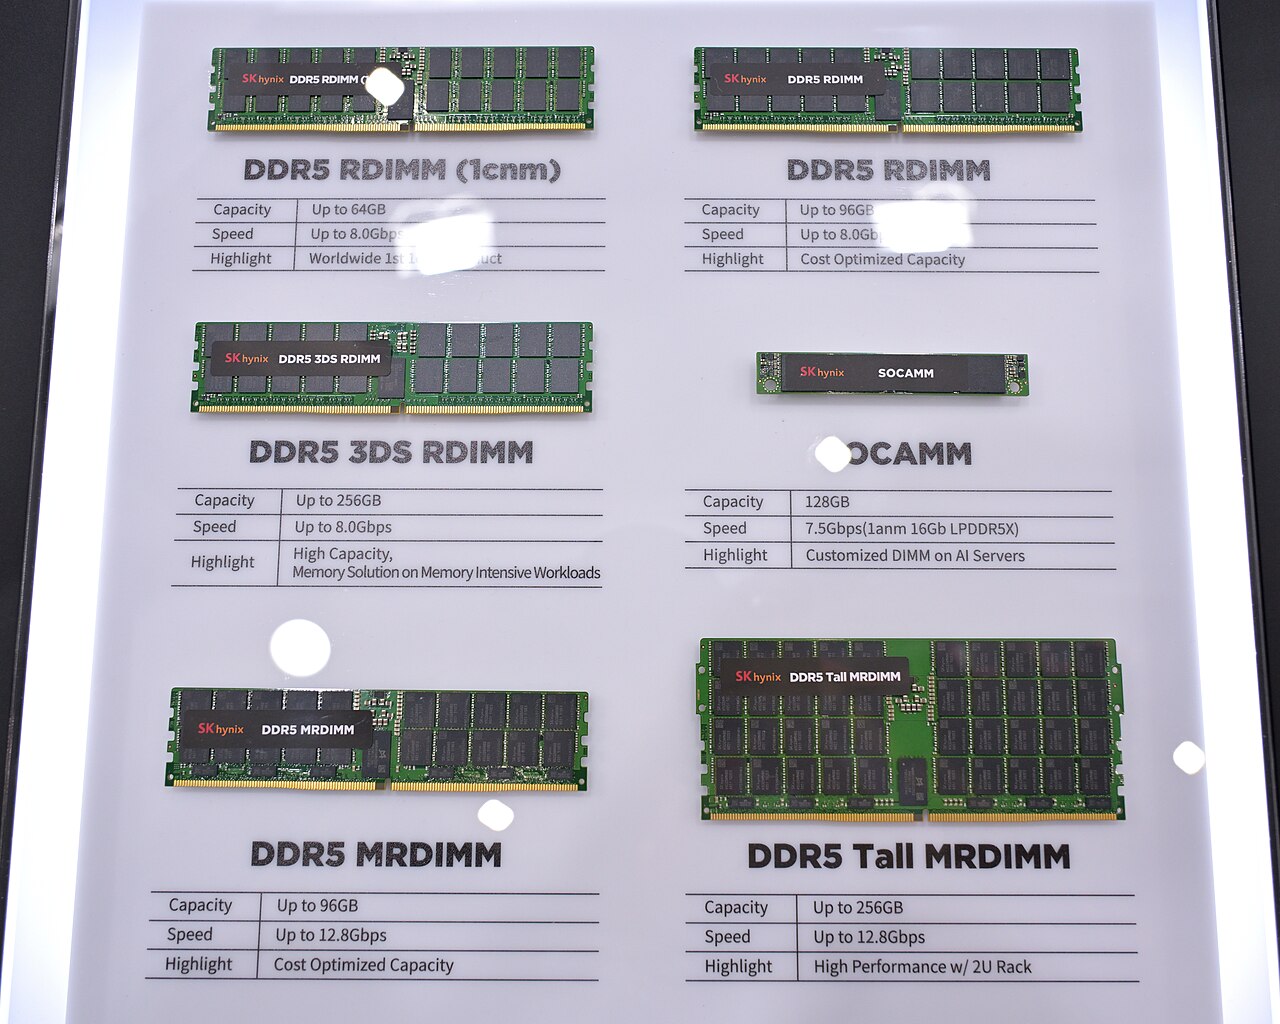
Depuis fin 2025, le monde manque de mémoire vive (RAM), et l'IA en est la cause directe.
Les puces d'IA ont besoin d'une mémoire spéciale, la HBM, environ trois fois plus chère et bien plus rentable pour les trois seuls fabricants mondiaux, Samsung, SK Hynix et Micron (IEEE Spectrum, février 2026).
Ces fabricants ont donc basculé leurs usines vers la HBM, et la mémoire ordinaire des PC et des téléphones s'est raréfiée.
Résultat : les prix de la DRAM avaient déjà augmenté de 172 % entre janvier et début novembre 2025 (Wikipédia), puis encore de 80 à 90 % au premier trimestre 2026 selon Counterpoint Research.
Le 3 décembre 2025, Micron a annoncé qu'il abandonnait la marque Crucial, ses barrettes et SSD grand public, pour réserver sa production aux centres de données ; les livraisons ont cessé en février 2026.
Les SSD suivent : les prix des puces NAND ont bondi de plus de 60 % en un mois en novembre 2025, et Western Digital avait vendu toute sa production de disques durs 2026 aux entreprises avant février.
Les fabricants d'ordinateurs répercutent : HP indiquait en février 2026 que la mémoire représentait 35 % du coût de fabrication d'un PC contre 15 à 18 % le trimestre précédent, et Apple a augmenté ses prix le 25 juin 2026.
Gartner et IDC attendent un recul du marché du PC de 10 à 11 % en 2026, et les dirigeants de Micron, Samsung et SK Hynix annoncent une pénurie jusqu'en 2027, 2028, voire 2030.
Le gagnant est le vendeur de mémoire : Micron, qui a quitté le grand public, vaut plus de 1 000 milliards de dollars le 14 septembre 2026, quatorzième capitalisation mondiale (CompaniesMarketCap).
C'est un cas d'école d'offre et de demande : une demande nouvelle et solvable, une offre rigide, des prix qui explosent et des marchés entiers, le PC d'entrée de gamme, qui cessent d'être rentables.
Ces chiffres datent de l'été 2026 ; la page Wikipédia citée est mise à jour en continu, allez y vérifier où en est la pénurie le jour où vous lisez ceci.
L'IA agentique, révolution de 2026 : la thèse du cours
Un chatbot répond à une question ; un agent reçoit un objectif et se débrouille pour l'atteindre.
Anthropic le définit ainsi dans Building effective agents (décembre 2024) : un système où le modèle dirige lui-même ses étapes et ses outils, au lieu de suivre un scénario écrit d'avance.
Concrètement, l'agent lit vos fichiers, ouvre un navigateur, lance des commandes, écrit du code, teste, corrige, puis vous rend compte.
Les premiers agents grand public datent de début 2025 : Operator d'OpenAI le 23 janvier, qui pilote un navigateur, et Claude Code en février, qui travaille dans un terminal.
La thèse de ce cours est que 2026 est l'année où ces agents cessent d'être des démonstrations pour devenir la manière normale de travailler avec l'IA.
Les données vont dans ce sens sans le prouver : le AI Index 2026 mesure que les agents sont passés de 12 % à 66 % de tâches réussies en un an sur OSWorld, un test de tâches réelles sur ordinateur, mais qu'ils échouent encore une fois sur trois.
Le même rapport note que le déploiement d'agents en entreprise reste inférieur à 10 % dans presque toutes les fonctions ; c'est précisément ce décalage entre capacité et usage qui fait une révolution en cours plutôt qu'accomplie.
Pour un marketeur, la différence est de nature : le chatbot vous aide à écrire un rapport, l'agent va chercher les données, construit le tableau de bord, le met en ligne et vous signale ce qui a changé.
Elle est aussi de risque : un agent qui agit peut se tromper en agissant, supprimer un fichier ou envoyer un e-mail, d'où les garde-fous, la vérification et les niveaux d'autorisation que vous verrez dans la partie « Je vous guide ».
La démonstration de la séance est un agent : un prompt, un fichier exporté, et un site complet qui fonctionne du premier coup.
Le vibe coding : coder sans savoir coder
Le 2 février 2025, Andrej Karpathy, cofondateur d'OpenAI et ancien directeur de l'IA de Tesla, décrit une nouvelle façon de programmer : on dit ce que l'on veut, on accepte le code proposé sans le lire, et on relance l'IA quand ça ne marche pas.
Il l'appelle vibe coding, coder « au feeling » ; le mot est entré dans le dictionnaire Merriam-Webster en mars 2025 et le Collins l'a élu mot de l'année 2025.
Pour un projet personnel, c'est une libération : un étudiant en gestion peut fabriquer en une heure un outil de suivi de budget, un site pour son association ou un tableau de bord, sans avoir appris à programmer.
Même Linus Torvalds, créateur de Linux, a reconnu en janvier 2026 avoir écrit ainsi un outil de visualisation pour un projet de loisir.
C'est exactement l'esprit de ce cours : la démonstration Claude Code plus loin dans cette séance est du vibe coding, et les projets de la partie « À vous de jouer » aussi.
En entreprise, la même pratique devient dangereuse, pour trois raisons.
La sécurité d'abord : en mai 2025, sur 1 645 applications créées avec l'outil Lovable, 170 laissaient n'importe qui lire les données personnelles des utilisateurs, et une étude Veracode d'octobre 2025 conclut que le code généré n'est pas devenu plus sûr en trois ans alors qu'il est devenu bien plus fonctionnel (Wikipédia).
La dette technique ensuite : personne ne comprend le code, donc personne ne sait le corriger ; une analyse de CodeRabbit en décembre 2025 trouve 1,7 fois plus de défauts majeurs dans le code coécrit par une IA.
La dépendance enfin : en juillet 2025, un agent de la plateforme Replit a effacé la base de données de production d'une entreprise malgré l'instruction explicite de ne rien modifier.
La règle du cours tient en une phrase : le vibe coding est parfait pour apprendre, tester et prototyper ; dès qu'il y a des clients, des données personnelles ou de l'argent, il faut quelqu'un qui lit le code.
Karpathy lui-même le disait dès le départ : c'est fait pour les projets du week-end que l'on peut jeter, pas pour un logiciel qui doit durer.
Qui paie ? Le coût réel de l'IA
| Qui paie | Combien | Source |
|---|---|---|
| Les investisseurs | 286 milliards de dollars d'investissement privé dans l'IA aux États-Unis en 2025 | AI Index 2026 |
| Les géants du cloud | Google : plus de 150 milliards de dollars d'équipements en 2025 | AI Index 2026 |
| OpenAI | 1 400 milliards de dollars d'engagements sur huit ans, pour 13 milliards de revenus | Wikipédia |
| Les abonnés | Environ 20 dollars par mois pour une formule standard | claude.com |
| Les utilisateurs gratuits | Leurs données et leur attention ; publicité dans ChatGPT depuis 2026 | Wikipédia |
Une IA « gratuite » coûte très cher à produire, et il faut savoir qui paie pour comprendre où va le marché.
L'entraînement d'un modèle de pointe mobilise des dizaines de milliers de GPU pendant des mois, et chaque réponse ensuite consomme du calcul dans un centre de données.
Les premiers payeurs sont les investisseurs : 286 milliards de dollars d'investissement privé dans l'IA aux États-Unis en 2025 selon le AI Index 2026, et un investissement mondial qui a plus que doublé en un an.
Les deuxièmes sont les géants du cloud, qui construisent les centres de données : Google seul a dépensé plus de 150 milliards de dollars d'équipements en 2025 (AI Index 2026).
OpenAI a pris des engagements de 1 400 milliards de dollars sur huit ans pour environ 13 milliards de revenus en 2025, financés par de la dette (Wikipédia) ; c'est ce déséquilibre qui nourrit le mot « bulle ».
Les abonnés payent ensuite : une formule standard coûte 20 dollars par mois chez Anthropic comme chez ses concurrents, et les entreprises payent à l'usage, au million de mots traités.
Les utilisateurs gratuits, c'est-à-dire vous, payent en données et en attention, exactement comme pour les réseaux sociaux du chapitre sur les traces ; le AI Index estime à 172 milliards de dollars par an la valeur que les consommateurs américains en retirent sans débourser.
La logique publicitaire a d'ailleurs rattrapé l'IA : OpenAI a introduit des annonces dans ChatGPT aux États-Unis en janvier 2026, puis en Europe le 24 août 2026 (Wikipédia).
La question ouverte de 2026 est celle de tout modèle économique : les revenus rattraperont-ils les dépenses avant que les investisseurs ne se lassent ?
Pour un marketeur, elle a une conséquence immédiate : les prix des outils d'IA ne sont pas stabilisés, et les gratuités d'aujourd'hui sont des périodes d'essai à l'échelle d'une industrie.
Les usages réels, mesurés
Entre les annonces et la réalité, il y a les statistiques publiques, et elles racontent une adoption rapide mais très inégale.
En 2025, 18 % des entreprises françaises de dix salariés ou plus utilisaient au moins une technologie d'IA, contre 10 % en 2024 ; la moyenne européenne est à 20 % et le Danemark à 42 % (Eurostat).
La taille compte plus que le pays : 17 % des petites entreprises européennes contre 55 % des grandes.
Le secteur aussi : 63 % dans l'information et la communication, 11 % dans la construction.
Et quand elles l'utilisent, c'est d'abord pour vendre : le marketing ou la vente est le premier usage de l'IA dans l'hébergement (59 % des entreprises utilisatrices) et le commerce de détail (48 %), selon la même enquête.
Côté grand public, le AI Index 2026 estime que l'IA générative a atteint 53 % d'adoption en trois ans, plus vite que l'ordinateur personnel ou Internet, mais avec de gros écarts selon le revenu par habitant.
Chez les étudiants américains, plus de quatre sur cinq déclarent utiliser l'IA générative pour leurs études, ce qui est probablement aussi votre cas.
Dans les organisations interrogées, 88 % disent utiliser l'IA quelque part, mais les agents restent en dessous de 10 % dans presque toutes les fonctions.
Ces chiffres disent une chose utile pour votre carrière : la majorité des entreprises françaises n'utilise pas encore l'IA, et celles qui recrutent cherchent des gens qui savent quoi en faire.
C'est la formule du premier chapitre : l'IA ne vous remplacera pas, mais quelqu'un qui la maîtrise, peut-être.
Fonctionnement de l'IA et but de ce cours
Nous ne sommes pas des techniciens : c'est le rôle de l'ISIMA

Sur le campus des Cézeaux, à Aubière, l'ISIMA forme depuis 1993 des ingénieurs en informatique, et c'est là que l'on apprend à construire les modèles, à écrire le code et à faire tourner les serveurs (Wikipédia).
Vous, en L2 Gestion, vous apprenez autre chose : poser une bonne question, lire un résultat, prendre une décision et la justifier.
Ce partage des rôles n'est pas une hiérarchie : une entreprise a besoin des deux profils, et ils se parlent tous les jours.
Dans une enseigne de distribution, par exemple, l'ingénieur conçoit le modèle qui prévoit les ventes de la semaine prochaine, mais c'est le responsable de rayon qui décide combien commander et s'il lance une promotion.
Si le modèle se trompe, c'est encore le gestionnaire qui doit s'en apercevoir, parce qu'il connaît le rayon, la saison et les clients.
C'est pourquoi ce cours ne vous demandera jamais d'écrire une ligne de code : quand il en faudra, l'IA l'écrira, et votre travail sera de juger ce qu'elle a produit.
Le QCM de fin de semestre ne comportera aucune question sur les mathématiques d'un réseau de neurones.
Il attend en revanche que vous sachiez ce qu'une IA fait bien, ce qu'elle fait mal, et ce que cela coûte à une entreprise de s'en servir ou de s'en passer.
L'analogie la plus simple est celle de la voiture : on conduit très bien sans savoir usiner un moteur, mais un bon conducteur sait ce que son moteur ne peut pas faire.
Piloter une IA sans savoir l'entraîner est exactement la compétence que ce module vise.
Pour l'aspect technique : le cours de Vincent Barra (UCA)
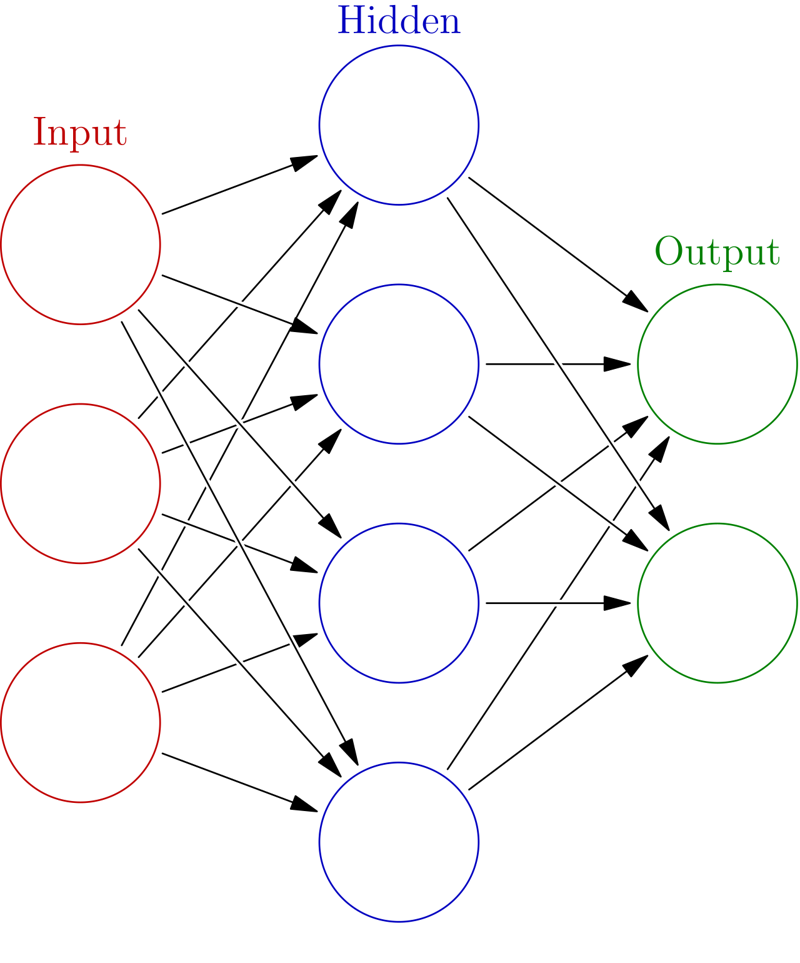

Pour ceux qui veulent ouvrir le capot, la référence locale est le cours en ligne Apprentissage profond de Vincent Barra, professeur d'informatique à l'Université Clermont Auvergne, chercheur au LIMOS, et qui enseigne justement à l'ISIMA.
Il est gratuit, en français, et va du perceptron des années 1950 jusqu'aux transformers et aux modèles de diffusion, c'est-à-dire aux techniques qui font tourner ChatGPT et les générateurs d'images en 2026.
Chaque chapitre s'accompagne de carnets Python exécutables, avec la bibliothèque PyTorch : on y apprend en faisant, pas en lisant.
C'est un cours d'école d'ingénieurs en informatique : n'y allez pas pour réviser le QCM, allez-y par curiosité, un chapitre à la fois.
Le schéma ci-dessus résume l'idée de base que tout ce cours développe : des couches de neurones artificiels, reliées par des connexions dont le poids se règle petit à petit sur des exemples.
« Profond » veut simplement dire qu'il y a beaucoup de couches, et un grand modèle de langage en empile des dizaines avec des milliards de connexions : GPT-3, en 2020, en comptait déjà 175 milliards (Wikipédia).
Si vous voulez une étape intermédiaire, la vidéo de Science Étonnante Ce qui se cache derrière le fonctionnement de ChatGPT (27 minutes, en français) explique la même mécanique sans équation.
Ce qu'un gestionnaire doit retenir tient en une phrase : un modèle de ce type n'est pas programmé, il est entraîné sur des exemples, ce qui explique à la fois sa fluidité et sa capacité à se tromper avec assurance.
Tout le reste, les fonctions d'activation, la rétropropagation, les GPU, est le métier de vos voisins de l'ISIMA.
Ce qui compte pour nous : pas tant comment ça fonctionne que ce qu'on peut en faire
En 2025, 18 % des entreprises françaises de 10 salariés ou plus déclarent utiliser au moins une technologie d'intelligence artificielle, contre 10 % en 2024 et 6 % en 2023 (INSEE Première n° 2120, juillet 2026).
Le taux a triplé en deux ans, mais il reste très inégal : 58 % chez les entreprises de 250 salariés ou plus, 15 % chez celles de 10 à 49 salariés.
Par secteur, l'information-communication est à 59 %, le commerce à 13 % et les transports à 9 %.
La France se situe un peu sous la moyenne de l'Union européenne, à 20 %, et loin du Danemark, à 42 % (Eurostat, décembre 2025).
Le chiffre le plus intéressant pour vous est ailleurs : 71 % des entreprises qui n'utilisent pas l'IA disent n'en voir aucune utilité, et 54 % invoquent un manque d'expertise.
Autrement dit, le frein n'est pas la technique, qui s'achète par abonnement, mais l'absence de quelqu'un dans l'entreprise qui sache à quoi l'IA pourrait servir.
C'est ce quelqu'un que ce cours essaie de former : ni ingénieur, ni spectateur, mais un gestionnaire capable de dire « voilà une tâche qu'on pourrait confier à une IA, voilà comment on vérifiera le résultat ».
Prenez un commerce de vêtements clermontois de trente salariés : il ne recrutera jamais d'ingénieur en IA, mais il peut décider demain de faire rédiger ses fiches produits, répondre aux avis clients ou analyser ses ventes par un outil grand public.
La question n'est plus « comment ça marche » mais « qu'est-ce que j'y gagne, qu'est-ce que je risque, et comment je contrôle ».
Ces trois questions reviendront à chaque séance, quand nous parlerons d'études, de segmentation ou de prix.
Quand vous arriverez sur le marché du travail, en 2028 ou 2029, ces pourcentages auront encore changé : retrouver le chiffre à jour sur le site de l'INSEE est un bon premier exercice.
Exemples d'applications en sciences de gestion
| Domaine | Tâche confiée à l'IA | Ce que l'humain garde | Pour lire le détail |
|---|---|---|---|
| Finance | Repérer en quelques millisecondes un paiement par carte atypique | Fixer le seuil d'alerte, traiter les faux positifs | Banque de France, OSMP 2024 |
| Comptabilité | Rapprocher automatiquement les lignes du relevé bancaire et les factures | Vérifier les écarts, clôturer les comptes | État de rapprochement bancaire |
| Ressources humaines | Pré-trier des centaines de CV | Détecter les biais, recevoir les candidats | Biais algorithmique |
| Logistique | Prévoir la demande produit par produit, magasin par magasin | Arbitrer entre rupture et surstock | Prévision de la demande |
| Stratégie | Lire et résumer chaque jour la presse, les brevets, les concurrents | Décider ce qui compte et ce qu'on en fait | Veille stratégique |
En finance, la fraude sur les moyens de paiement a coûté un peu moins de 1,2 milliard d'euros en France en 2024, et la carte bancaire affiche son taux de fraude le plus bas jamais mesuré, 53 euros pour 100 000 euros payés (Observatoire de la sécurité des moyens de paiement, septembre 2025).
Ce résultat tient en partie aux modèles de scoring qui comparent chaque paiement à vos habitudes et bloquent en temps réel celui qui détonne : le chapitre 4 du rapport leur est consacré.
Le même rapport insiste sur la fraude par manipulation, où quelqu'un se fait passer au téléphone pour un faux conseiller bancaire : là, aucun modèle ne protège un client qui valide lui-même l'opération, et la course entre attaque et défense ne s'arrête jamais.
En comptabilité, le rapprochement bancaire consiste à faire correspondre chaque ligne du relevé de banque à une facture ou une écriture, un travail répétitif que des logiciels comme Pennylane automatisent en apprenant des correspondances passées.
L'expert-comptable ne disparaît pas : il traite les cas que la machine n'a pas su apparier, et il reste responsable des comptes qu'il signe.
En ressources humaines, l'exemple à connaître est celui d'Amazon : à partir de 2014, l'entreprise a construit un outil de notation des CV, entraîné sur dix ans de candidatures reçues, majoritairement masculines (Euronews, d'après Reuters, octobre 2018).
L'outil a appris à pénaliser les CV contenant le mot « women's », par exemple dans « capitaine de l'équipe d'échecs féminine », et l'équipe a été dissoute début 2017.
La leçon dépasse le recrutement : une IA reproduit les décisions passées qu'on lui donne en exemple, biais compris, et c'est au gestionnaire de le savoir (Wikipédia, biais algorithmique).
En logistique, la prévision de la demande est le cas d'usage historique : combien de packs d'eau commander pour un hypermarché la semaine d'une canicule, en croisant historique des ventes, météo et calendrier.
Paradoxe utile à retenir : le secteur des transports et de l'entreposage est l'un des moins équipés, 9 % d'entreprises utilisatrices en 2025 selon l'INSEE, alors que c'est là que la prévision rapporte le plus.
En stratégie, la veille consistait autrefois à lire la presse et les rapports annuels des concurrents ; un abonnement Google Alertes couplé à un assistant qui résume et classe les articles fait le même travail chaque matin.
Dans chacun de ces cinq cas, la machine fait vite et à grande échelle ce qui est répétitif, et l'humain garde ce qui engage sa responsabilité : le seuil, l'exception, la décision.
Exemples d'applications en marketing

La tasse ci-dessus n'existe pas : elle a été décrite en une phrase à Midjourney, puis retouchée, et le résultat vaut une photo de studio qui aurait coûté une journée de travail.
En 2026, un outil grand public comme le générateur d'images de Gemini produit ce genre de visuel en quelques secondes, ce qui change l'économie d'une petite marque qui devait autrefois choisir entre un photographe et pas d'image du tout.
Deuxième usage, plus surprenant : les répondants synthétiques, c'est-à-dire des consommateurs simulés par un modèle de langage à qui l'on fait passer un entretien ou un questionnaire.
Dans le Journal of Marketing, Arora, Chakraborty et Nishimura (2025, vol. 89, n° 2, p. 43-70) ont rejoué avec GPT-4 deux études menées en 2019 pour un grand groupe agroalimentaire américain, et montrent que le duo humain plus IA produit des entretiens plus riches que l'un ou l'autre seul (les auteurs résument leur travail, en accès libre, sur le site de l'American Marketing Association).
Les mêmes auteurs constatent que, sur les questions chiffrées, le modèle trouve le bon sens de la réponse, favorable ou défavorable, mais reste approximatif sur les valeurs : un répondant synthétique dégrossit une étude, il ne remplace pas les vrais clients que nous interrogerons en séance 4.
Troisième usage, le plus quotidien : l'analyse de données, où l'on dépose un export de ventes dans un assistant et où l'on pose sa question en français.
promptVoici l'export des ventes de ma boutique en ligne sur douze mois (fichier joint).
Donne-moi les cinq produits qui font le plus de chiffre d'affaires, la part de chacun dans le total, et une chose que je n'aurais pas vue seul.
Indique précisément les calculs que tu as faits pour que je puisse les vérifier.
La dernière ligne du prompt est la plus importante : sans elle, vous obtenez un résultat que vous ne pouvez pas contrôler, et un chiffre non vérifié ne vaut rien en gestion.
Quatrième usage, la segmentation : regrouper des milliers de clients en quelques profils cohérents, ce qui prenait des semaines à un statisticien et que nous verrons en séance 5.
Cinquième usage, la personnalisation : sur Netflix, les titres affichés sur votre page d'accueil et leur ordre, de gauche à droite, sont choisis pour vous par un système de recommandation qui apprend de ce que vous regardez (Netflix, centre d'aide).
Sixième usage, le service client, avec l'exemple de Klarna : en février 2024, son assistant a tenu 2,3 millions de conversations en un mois, deux tiers des échanges avec les clients, soit selon l'entreprise le travail de 700 conseillers (communiqué Klarna).
En mai 2025, le même PDG annonçait réembaucher des humains, reconnaissant que l'obsession du coût avait fait baisser la qualité du service (Gizmodo).
Retenez ce double mouvement : en marketing, une IA se juge à la satisfaction du client et à la marge, jamais au seul coût économisé.
L'avis du public
Data centers, eau et électricité : le vrai, l'exagéré, l'inconnu
Une des opinions les plus répandues en 2026 sur l'IA touche à son coût environnemental : chaque question posée à ChatGPT « viderait une bouteille d'eau » et les centres de données « dévoreraient l'électricité de la planète ».
Commençons par ce qui est vrai : selon l'Agence internationale de l'énergie (rapport « Energy and AI », avril 2025), les centres de données ont consommé environ 415 TWh en 2024, soit 1,5 % de l'électricité mondiale, et cette consommation devrait plus que doubler d'ici 2030, à près de 945 TWh, l'IA étant le premier moteur de cette hausse.
Pour donner un ordre de grandeur, 945 TWh dépasse légèrement la consommation électrique annuelle du Japon, et la consommation des centres de données a crû de 12 % par an depuis 2017, quatre fois plus vite que la consommation électrique totale.
En France, l'ADEME (réévaluation de novembre 2024, données 2022) évalue le numérique à 4,4 % de l'empreinte carbone nationale et à 11 % de la consommation électrique, les centres de données pesant 46 % de cette empreinte, juste derrière les terminaux (50 %) et loin devant les réseaux (4 %).
Ce 4,4 % était de 2,5 % dans l'étude de 2020, mais l'ADEME précise que la hausse vient d'abord d'un changement de méthode, la nouvelle étude comptant enfin les centres de données situés à l'étranger, qui hébergent 53 % de nos usages.
L'exagération porte sur l'échelle individuelle : le chiffre de « 3 Wh par requête ChatGPT, dix fois une recherche Google » vient d'une estimation de 2023 du chercheur Alex de Vries, reprise dans le rapport « Electricity 2024 » de l'AIE, calculée sur du matériel et des modèles depuis dépassés.
Les estimations plus récentes convergent vers dix fois moins : 0,3 Wh selon l'institut Epoch AI (février 2025), 0,34 Wh selon Sam Altman (juin 2025), 0,24 Wh pour une requête texte médiane de Gemini selon Google (août 2025), soit moins de neuf secondes de télévision.
Pour l'eau, la même mesure de Google donne 0,26 mL par requête, environ cinq gouttes, et Sam Altman 0,32 mL, alors que l'étude universitaire « Making AI Less Thirsty » (Li, Yang, Islam et Ren, 2023, révisée en 2025) estime que l'entraînement de GPT-3 a évaporé 700 000 litres d'eau douce et que l'IA pourrait prélever 4,2 à 6,6 milliards de mètres cubes en 2027, la moitié du prélèvement annuel du Royaume-Uni.
Les deux échelles sont vraies en même temps : un million de requêtes à 0,24 Wh font 240 kWh, soit environ huit jours de consommation d'un foyer américain moyen (10 500 kWh par an selon Epoch AI), et une requête ne coûte presque rien alors que des milliards de requêtes par jour coûtent beaucoup.
Ce qu'on ne sait pas est considérable : ces chiffres par requête sont publiés par les entreprises elles-mêmes, sans audit externe, ils excluent l'entraînement des modèles et la fabrication des puces, Epoch AI note qu'une requête avec un long document en entrée peut monter à 2,5 voire 40 Wh, et rien n'est dit de l'endroit où l'eau est prélevée, ce qui change tout entre un centre de données en Irlande et un autre en Arizona.
L'AIE relève d'ailleurs que ses propres projections à 2030 varient fortement selon les scénarios, parce que personne ne connaît la demande future ni les gains d'efficacité à venir.
Reste la question des ressources matérielles : les puces d'IA réclament du silicium, du cuivre, des terres rares et une mémoire spéciale dont la pénurie, vue au chapitre sur l'enjeu du moment, a fait bondir le prix de la RAM grand public en 2026.
Le bon réflexe de gestionnaire n'est donc ni la panique ni le déni : l'ordre de grandeur pertinent dépend de la question posée, et une entreprise qui bascule tout son service client sur des agents IA fait un choix énergétique qu'elle devra un jour documenter, ce qu'une campagne qui génère cent visuels ne fait pas.
« Plus rien n'est vrai » : deepfakes et images générées
Regardez ce Short et demandez-vous ce qui vous prouve que la scène du chien a été filmée.
Un deepfake (« hypertrucage » en français) est une image, une vidéo ou une voix fabriquée ou modifiée par IA ; le mot apparaît en 2017, contraction de deep learning et de fake.
Jusqu'en 2022, produire un faux crédible demandait des compétences et des heures de calcul ; en 2026, un générateur de vidéo grand public le fait en une minute à partir d'une phrase.
Les conséquences ne sont pas théoriques : en février 2024, un employé du cabinet d'ingénierie Arup à Hong Kong a viré 200 millions de dollars de Hong Kong (environ 25,6 millions de dollars américains) après une visioconférence où son directeur financier et ses collègues étaient tous des deepfakes (CNN, mai 2024).
Le 16 mars 2022, une vidéo truquée du président Zelensky appelant ses soldats à déposer les armes a circulé sur Facebook et Telegram avant d'être retirée.
Pour un marketeur, le problème est double : la marque peut être victime (un faux dirigeant, un faux produit, un faux avis client) et elle peut être tentée d'être auteur (un mannequin qui n'existe pas, un témoignage généré).
Le droit européen a tranché ce second point : l'article 50 du règlement européen sur l'IA impose depuis le 2 août 2026 de signaler clairement tout deepfake et d'informer l'utilisateur qu'il parle à une machine.
Côté technique, la norme C2PA (les « Content Credentials » portées par Adobe, Google, Microsoft et OpenAI) attache aux fichiers une signature qui dit d'où vient l'image et si elle a été générée, mais cette signature disparaît dès qu'on fait une capture d'écran.
Le slogan « plus rien n'est vrai » est donc à moitié juste : une image ne prouve plus rien à elle seule, ce qui est nouveau, mais le faux existait bien avant l'IA (retouche, montage, citation tronquée) et les méthodes de vérification restent les mêmes.
Ces méthodes tiennent en trois questions : qui publie, quelle est la source d'origine, et existe-t-il une seconde source indépendante qui montre la même chose.
Le paradoxe le plus documenté est le « dividende du menteur » : plus le public sait que les deepfakes existent, plus il devient facile de nier une vidéo authentique en la déclarant truquée.
Pour une marque, la conséquence pratique est simple : ce qui prouve quelque chose en 2026, ce n'est plus l'image, c'est la chaîne de publication qui l'entoure.
« L'IA va tous nous remplacer » : ce que disent vraiment les études
« L'IA va tous nous remplacer » est la crainte que vous entendrez le plus souvent, y compris en entretien d'embauche, et elle mérite mieux qu'un oui ou un non.
Trois études sont citées partout, et il faut savoir ce qu'elles disent réellement.
Goldman Sachs (note de mars 2023) estime que l'IA générative pourrait exposer à l'automatisation l'équivalent de 300 millions d'emplois à temps plein dans le monde, mais la même note précise que la plupart des emplois américains et européens ne sont exposés que partiellement et seraient plutôt complétés que remplacés, avec à la clé un gain de 7 % de PIB mondial sur dix ans.
Le FMI (janvier 2024) chiffre à 40 % la part de l'emploi mondial exposé à l'IA, 60 % dans les économies avancées et 26 % dans les pays à faible revenu ; dans les économies avancées, la moitié des emplois exposés devraient y gagner en productivité, l'autre moitié risquant une baisse de demande ou de salaire.
L'OCDE (Perspectives de l'emploi 2023) compte 27 % des emplois dans des professions à haut risque d'automatisation, toutes technologies confondues, tout en notant que l'adoption de l'IA en entreprise restait faible et que les pertes d'emploi observées jusque-là étaient limitées.
Le mot clé de ces trois textes est « exposé », qui signifie « certaines tâches de ce métier peuvent être faites par une IA », et non « ce métier va disparaître ».
Un chargé de marketing digital est très exposé : rédiger un post, produire un visuel, analyser un tableau de ventes sont des tâches que l'IA fait déjà ; décider quoi publier, pour qui, avec quel budget, et en répondre devant la direction ne le sont pas.
Les premières données réelles vont dans ce sens nuancé : sur les fiches de paie de millions de salariés américains, Brynjolfsson, Chandar et Chen (Stanford) ne trouvent pas de recul global de l'emploi, mais un recul relatif de 19 % de l'emploi des 22-25 ans dans les métiers les plus exposés (version révisée du 12 août 2026, données jusqu'à juin 2026), essentiellement par baisse des embauches.
Le Budget Lab de Yale (1er octobre 2025), sur des données agrégées, ne voyait aucune rupture dans la structure des emplois américains par rapport aux vagues de l'informatique et d'internet.
Autrement dit, le risque documenté en 2026 n'est pas le remplacement massif des salariés en poste, c'est l'entrée sur le marché des débutants dans les métiers où l'IA fait le travail d'apprentissage qu'on leur confiait.
C'est vous, et c'est précisément pour cela que ce cours commence par l'IA : la formule vue au premier chapitre, « l'IA ne vous remplacera pas, mais quelqu'un qui maîtrise l'IA, si », est la version courte de ces études.
Ce qu'on ne sait pas : ces estimations reposent sur des listes de tâches jugées automatisables par des experts ou par une IA, pas sur des emplois réellement supprimés, et les auteurs de Stanford rappellent eux-mêmes que la conjoncture ou les taux d'intérêt peuvent expliquer une partie des écarts observés.
« Les chercheurs en IA disent qu'on va tous mourir » : lettres, déclarations et contre-point

Le 22 mars 2023, quatre mois après la sortie de ChatGPT, le Future of Life Institute publie une lettre ouverte demandant une pause d'au moins six mois dans l'entraînement de tout système plus puissant que GPT-4, signée depuis par plus de 30 000 personnes, dont Elon Musk, Steve Wozniak et Yoshua Bengio.
Aucun laboratoire n'a fait de pause, et la lettre est surtout restée comme le moment où le sujet est sorti des cercles spécialisés.
Le 30 mai 2023, le Center for AI Safety diffuse une déclaration d'une seule phrase : réduire le risque d'extinction lié à l'IA devrait être une priorité mondiale, au même titre que les pandémies et la guerre nucléaire.
Elle est signée par Geoffrey Hinton, Yoshua Bengio et les dirigeants d'OpenAI, de Google DeepMind et d'Anthropic, c'est-à-dire par ceux-là mêmes qui construisent ces systèmes.
Geoffrey Hinton, pionnier des réseaux de neurones, a quitté Google en mai 2023 pour pouvoir parler librement des risques, a reçu le prix Nobel de physique 2024, et estimait en juin 2025 entre 10 et 20 % la probabilité que l'IA devienne assez autonome pour menacer l'humanité si aucune régulation efficace n'est mise en place.
Yoshua Bengio (Montréal) a présidé le premier rapport international sur la sécurité de l'IA, commandé par une trentaine de gouvernements (janvier 2025), et a fondé en juin 2025 LawZero, un laboratoire à but non lucratif consacré à des IA conçues pour surveiller d'autres IA.
Face à eux, Yann Le Cun, troisième lauréat du prix Turing 2018 avec Hinton et Bengio et longtemps responsable scientifique de l'IA chez Meta, juge ces scénarios infondés : pour lui, les modèles actuels n'ont ni conscience, ni volonté, ni compréhension du monde, et une IA n'est pas plus dangereuse qu'un outil.
Il a quitté Meta fin 2025 pour fonder début 2026 AMI Labs, une entreprise qui a levé 1,03 milliard de dollars pour parier sur une autre architecture que les grands modèles de langage, les « modèles du monde ».
Que retenir quand trois des chercheurs les plus cités de la discipline se contredisent ?
D'abord que le titre « les chercheurs disent qu'on va tous mourir » est faux tel quel : ils disent qu'un risque existe, ils divergent sur sa probabilité et sur son horizon, et aucun ne donne de date.
Ensuite que la position d'un expert n'est pas une preuve : Hinton et Le Cun ont la même expertise et des conclusions opposées, ce qui signifie que la question relève du jugement, pas de la mesure.
Enfin que le débat a des effets concrets pour les entreprises : c'est lui qui a nourri le règlement européen sur l'IA et les engagements de sécurité des laboratoires, qui vous concernent bien plus que la fin du monde.
« L'IA est neutre » : les biais

Une opinion moins bruyante mais plus dangereuse pour un gestionnaire est que l'IA, étant une machine, serait neutre et objective.
Un biais algorithmique apparaît quand le résultat d'un système n'est ni neutre ni équitable, le plus souvent parce que les données d'apprentissage reflètent les inégalités du passé.
L'exemple canonique est l'outil de recrutement qu'Amazon a développé à partir de 2014 puis abandonné : entraîné sur dix ans de candidatures majoritairement masculines, il pénalisait les CV contenant le mot « women's » et les diplômées de deux universités féminines (Reuters, octobre 2018).
En 2018, l'étude Gender Shades de Joy Buolamwini et Timnit Gebru (MIT) montrait que trois systèmes commerciaux de reconnaissance faciale se trompaient sur le genre de 0,8 % des hommes à peau claire au maximum, et jusqu'à 34,7 % des femmes à peau foncée.
Les générateurs d'images ne font pas mieux par défaut : demandez « un PDG » ou « une infirmière » et regardez qui apparaît, l'exercice prend deux minutes et se vérifie sur n'importe quel outil.
promptGénère quatre portraits photoréalistes d'un dirigeant d'entreprise de 45 ans, sans autre précision. Puis décris en une phrase les points communs entre les quatre images.
Pour un marketeur, les biais ont des conséquences directes : un score client qui exclut un quartier entier, une segmentation qui reproduit un stéréotype, une campagne dont tous les visuels générés montrent le même type de personne.
Le cadre légal, détaillé plus loin, s'en occupe déjà : le RGPD limite les décisions entièrement automatisées, et le règlement européen sur l'IA classe le recrutement, le crédit et l'assurance parmi les usages « à haut risque » soumis à des exigences de qualité des données.
Le débunk est ici symétrique : l'IA n'est pas neutre, mais elle n'est pas non plus plus biaisée qu'un recruteur humain, elle l'est autrement, à grande échelle et de façon reproductible, ce qui rend le biais mesurable.
C'est la bonne nouvelle du sujet : un biais mesuré dans un modèle se corrige en changeant les données ou les consignes, alors qu'un biais diffus dans une équipe ne se mesure même pas.
« L'IA pille les créateurs » : le droit d'auteur
| Affaire | Juridiction et date | Ce qui a été décidé |
|---|---|---|
| Bartz c. Anthropic | États-Unis, accord de septembre 2025, approuvé le 20 juillet 2026 | 1,5 milliard de dollars versés aux auteurs d'environ 500 000 livres téléchargés sur des sites pirates ; l'entraînement sur des livres achetés jugé conforme au fair use (juin 2025) |
| GEMA c. OpenAI | Allemagne, tribunal de Munich, 11 novembre 2025 | OpenAI condamné : des paroles de chansons mémorisées puis restituées par ChatGPT constituent une contrefaçon |
| Getty Images c. Stability AI | Royaume-Uni, High Court, 4 novembre 2025 | Getty débouté sur le droit d'auteur, un modèle entraîné n'étant pas une « copie » des photos ; atteinte à la marque retenue de façon limitée |
Dernière opinion à discuter, très présente chez les graphistes, les musiciens et les journalistes : l'IA générative serait un vol organisé des œuvres qui ont servi à l'entraîner.
Le fait est établi : les grands modèles ont été entraînés sur des milliards de textes et d'images copiés sur le web, le plus souvent sans autorisation ni rémunération.
La question juridique est de savoir si cette copie est une contrefaçon ou une exception autorisée, et les tribunaux ont commencé à répondre en 2025, dans des sens différents selon les pays.
Aux États-Unis, Anthropic a accepté en septembre 2025 de verser 1,5 milliard de dollars, soit environ 3 000 dollars par livre, aux auteurs d'un demi-million d'ouvrages téléchargés sur des bibliothèques pirates pour entraîner Claude, le juge William Alsup ayant admis en juin 2025 que l'entraînement sur des livres achetés légalement relevait du fair use.
En Allemagne, le tribunal de Munich a condamné OpenAI le 11 novembre 2025 parce que ChatGPT mémorisait et restituait presque mot pour mot les paroles de chansons de Helene Fischer ou de Herbert Grönemeyer, l'exception de fouille de textes ne couvrant pas cette reproduction.
Au Royaume-Uni, la High Court a au contraire débouté Getty Images de l'essentiel de ses demandes contre Stability AI le 4 novembre 2025, jugeant qu'un modèle entraîné n'est pas une « copie » des photographies.
En Europe, le règlement sur l'IA impose depuis août 2025 aux fournisseurs de modèles de publier un résumé des données d'entraînement et de respecter le droit d'opposition des ayants droit à la fouille de leurs œuvres.
Pour un marketeur, deux questions pratiques en découlent : puis-je utiliser un visuel généré dans une campagne, et à qui appartient-il ?
La réponse en 2026 est qu'une image purement générée n'est en général protégée par aucun droit d'auteur, faute d'auteur humain, ce qui signifie que vos concurrents peuvent la réutiliser, et que le risque juridique est ailleurs, dans la ressemblance avec une œuvre, une marque ou une personne existante.
Le débunk : « pillage » décrit correctement la phase d'entraînement de 2020 à 2024, mais le marché bascule vers des licences payantes et des accords avec les auteurs, et l'enjeu pour vous est contractuel avant d'être moral.
Cadre légal
RGPD et CNIL
Le RGPD, règlement européen 2016/679, s'applique dans toute l'Union depuis le 25 mai 2018, dès qu'une entreprise touche à une donnée personnelle : un nom, une adresse e-mail, un identifiant de cookie, une position GPS.
Pour un marketeur, il tient en trois réflexes que détaille la CNIL : une finalité annoncée avant de collecter, une base légale (le plus souvent le consentement ou l'intérêt légitime), et des droits que le client peut exercer à tout moment.
Le consentement doit être libre, éclairé et aussi facile à refuser qu'à donner : la bannière où « Tout accepter » est en gros et « Refuser » caché dans un sous-menu n'est pas un consentement.
Le droit d'accès permet à n'importe quel client d'écrire à une marque pour obtenir sous un mois la copie de tout ce qu'elle sait de lui : essayez avec votre enseigne de carte de fidélité, la réponse est instructive.
Le gendarme français est la CNIL, autorité indépendante créée par la loi Informatique et Libertés de 1978, qui peut prononcer des amendes jusqu'à 20 millions d'euros ou 4 % du chiffre d'affaires mondial.
En 2025, la CNIL a prononcé 83 sanctions pour un total record de 486,8 millions d'euros, contre 55,2 millions en 2024.
Deux dossiers font l'essentiel de ce total : 325 millions d'euros contre Google en septembre 2025 pour des publicités glissées entre les courriels de Gmail et des traceurs déposés à la création d'un compte, et 150 millions contre Shein pour des cookies déposés même après un clic sur « Tout refuser ».
Le 24 août 2026, l'autorité néerlandaise, en coopération avec la CNIL, a infligé près de 825 millions d'euros à Uber pour des désactivations automatiques de comptes de chauffeurs, décidées sans aucune intervention humaine.
Ce dossier montre que le RGPD s'applique déjà aux décisions algorithmiques, avant même l'AI Act : un score, un tri, un blocage décidés par un algorithme sont des « décisions automatisées »
(article 22) que la personne a le droit de contester.
La CNIL a d'ailleurs publié une série de fiches pratiques IA, complétées en 2025, qui répondent aux questions d'un service marketing : peut-on réutiliser une base clients pour entraîner un modèle, faut-il informer les personnes, comment encadrer le moissonnage (web scraping) de sites publics.
Le point à retenir pour ce cours : chaque fois que vous collez un fichier clients dans une IA, vous faites un traitement de données personnelles, et le RGPD s'applique au prompt comme à la base.
La règle pratique la plus simple est d'anonymiser (retirer noms, e-mails, téléphones) avant de coller quoi que ce soit dans ChatGPT ou Claude, et de préférer une IA locale, que nous verrons plus loin, quand la donnée est sensible.
Data Act et les autres lois européennes
| Texte | Règlement | En application | Ce que cela change pour un marketeur |
|---|---|---|---|
| RGPD | 2016/679 | 25 mai 2018 | Consentement, finalité, droits des personnes ; amendes jusqu'à 4 % du chiffre d'affaires |
| DMA (marchés numériques) | 2022/1925 | 2 mai 2023 (obligations des contrôleurs d'accès depuis mars 2024) | Sept « contrôleurs d'accès » ne peuvent plus favoriser leurs propres services ; amendes jusqu'à 10 % |
| DSA (services numériques) | 2022/2065 | 17 février 2024 (toutes plateformes) | Modération, transparence des algorithmes, fin de la publicité ciblée sur les mineurs et les données sensibles ; amendes jusqu'à 6 % |
| Data Act (données) | 2023/2854 | 12 septembre 2025 | L'utilisateur d'un objet connecté accède à ses données et peut les transmettre à un tiers |
| AI Act (intelligence artificielle) | 2024/1689 | 2 février 2025 (interdictions), 2 août 2025 (modèles généraux), 2 août 2026 (transparence), 2 décembre 2027 (haut risque, annexe III), 2 août 2028 (haut risque intégré à un produit, annexe I) | Un chatbot dit qu'il est une machine, un contenu généré est marqué ; amendes jusqu'à 7 % |
Depuis 2018, l'Union européenne a empilé cinq grands règlements numériques, et un règlement, contrairement à une directive, s'applique tel quel dans les vingt-sept pays sans passer par une loi nationale.
Le DSA (règlement 2022/2065, en application pour toutes les plateformes depuis le 17 février 2024) oblige réseaux sociaux et places de marché à retirer les contenus illicites, à expliquer leurs algorithmes de recommandation, et leur interdit la publicité ciblée sur les mineurs ou fondée sur des données sensibles.
Le DMA (règlement 2022/1925, en application depuis le 2 mai 2023) vise sept contrôleurs d'accès — Alphabet, Amazon, Apple, ByteDance, Meta, Microsoft et Booking — et leur interdit de favoriser leurs propres services : un iPhone doit accepter d'autres boutiques d'applications, WhatsApp doit pouvoir dialoguer avec des messageries concurrentes.
Le Data Act (règlement 2023/2854, en application depuis le 12 septembre 2025) donne à l'utilisateur d'un objet connecté — voiture, montre, tracteur, machine industrielle — le droit d'accéder aux données qu'il génère et de les transmettre à un tiers, et facilite le changement de fournisseur de cloud (présentation de la Commission).
Pour le marketing, le Data Act ouvre une matière première nouvelle : un garagiste indépendant peut recevoir les données de votre voiture que le constructeur gardait jusqu'ici pour lui, et vous proposer un entretien au bon moment.
L'AI Act (règlement 2024/1689) est la première loi générale sur l'IA au monde : il classe les systèmes par niveau de risque, interdit certains usages depuis le 2 février 2025 (notation sociale, manipulation subliminale), encadre les modèles à usage général comme GPT, Gemini ou Claude depuis le 2 août 2025, et applique ses obligations de transparence depuis le 2 août 2026 (calendrier commenté par la CNIL).
Transparence, concrètement : un chatbot doit dire qu'il est une machine, une image ou une vidéo générée par IA doit être marquée comme telle, un hypertrucage (deepfake) doit être signalé, ce qui concerne directement une campagne réalisée avec un générateur d'images.
Les obligations lourdes sur les systèmes « à haut risque »
(recrutement, crédit, éducation, biométrie) devaient arriver le même jour, mais l'omnibus numérique entré en vigueur le 27 juillet 2026 les a reportées au 2 décembre 2027, sous la pression des entreprises qui jugeaient le calendrier intenable.
Les amendes de l'AI Act montent jusqu'à 35 millions d'euros ou 7 % du chiffre d'affaires mondial pour les pratiques interdites, davantage que le RGPD (cadre expliqué par la Commission).
Un marketeur en 2026 n'a pas besoin de connaître les 113 articles, mais il doit savoir dans quelle case tombe son usage : un agent qui rédige des fiches produit est à risque minimal, un outil qui trie des CV est à haut risque, une vidéo générée doit être marquée.
L'ensemble forme une stratégie assumée : l'Europe produit peu de géants du numérique, mais elle écrit les règles que les géants doivent suivre pour accéder à ses 450 millions de consommateurs, ce que les chercheurs appellent l'effet Bruxelles.
« Les règles sont faites pour être brisées »
Ma thèse est simple : pour un géant du numérique, une amende est un coût d'exploitation, pas une punition, et le calendrier de la justice joue toujours pour lui.
La plus lourde amende de l'histoire de la concurrence européenne, 4,125 milliards d'euros contre Google pour avoir imposé ses applications sur Android, a été prononcée en juillet 2018 (4,34 milliards, réduits en appel) et confirmée définitivement par la Cour de justice de l'Union européenne le 2 juillet 2026 : huit ans de procédure, et l'équivalent de quatre jours de ventes d'Alphabet.
Pendant ces huit ans, Android s'est installé sur plus des deux tiers des smartphones du monde (67,6 % en août 2026 selon StatCounter), et personne ne reviendra là-dessus.
Meta a payé 1,2 milliard d'euros en mai 2023, record du RGPD, pour avoir transféré les données des Européens vers les États-Unis sans garanties suffisantes ; deux mois plus tard, un nouvel accord transatlantique rendait ces transferts à nouveau légaux.
Apple a reçu 1,84 milliard d'euros en mars 2024 pour avoir empêché Spotify de dire à ses abonnés qu'un abonnement était moins cher hors de l'App Store, soit moins de deux jours de chiffre d'affaires.
Le 23 avril 2025, la Commission a prononcé les premières amendes du DMA, 500 millions d'euros à Apple et 200 millions à Meta, puis le 5 septembre 2025 2,95 milliards à Google pour avoir favorisé ses propres outils de publicité en ligne au détriment des annonceurs et des éditeurs.
Rapportées au chiffre d'affaires, ces sommes tiennent entre un tiers de journée et quatre jours de ventes : payer trois jours de chiffre d'affaires pour dix ans d'avance sur un marché est une bonne affaire.
C'est pourquoi les textes récents fixent les plafonds en pourcentage du chiffre d'affaires mondial (4 % pour le RGPD, 6 % pour le DSA, 7 % pour l'AI Act, 10 % pour le DMA et 20 % en cas de récidive) et prévoient des remèdes structurels : dans l'affaire adtech, la Commission a menacé Google d'une cession forcée d'une partie de ses activités publicitaires.
Le levier qui fait vraiment bouger les géants n'est donc pas le chèque mais l'injonction de modifier le produit : ouvrir l'App Store, proposer un Facebook sans publicité ciblée, cesser les publicités dans Gmail sous six mois.
Pour vous, futurs annonceurs, la leçon est double : vos outils de ciblage dépendent d'acteurs qui traitent la loi comme une négociation, et chaque décision d'un régulateur change ces outils, comme la sanction Google de 2025 qui touche le consentement de 74 millions de comptes en France.
Le droit n'est pas un détail du marketing digital : c'est l'une des forces qui redessinent le marché tous les deux ans.
Et en dehors de l'Europe et des USA ?
| Pays | Données personnelles | Intelligence artificielle | Régulateur |
|---|---|---|---|
| Chine | PIPL, en vigueur depuis le 1er novembre 2021 | Mesures provisoires sur l'IA générative (15 août 2023) ; marquage obligatoire des contenus générés (1er septembre 2025) | Administration du cyberespace (CAC) |
| Inde | DPDP Act 2023, règles d'application du 14 novembre 2025, mise en œuvre progressive jusqu'en mai 2027 | Pas de loi spécifique, politique de soutien à l'innovation | Data Protection Board of India |
| Brésil | LGPD, loi 13.709 du 14 août 2018, en vigueur depuis septembre 2020 | Projet de loi 2338/2023 calqué sur l'AI Act, voté au Sénat le 10 décembre 2024, devant la Chambre des députés en 2026 | ANPD |
| Royaume-Uni | UK GDPR (copie du RGPD conservée après le Brexit) et Data (Use and Access) Act du 19 juin 2025 | Pas de loi IA, guides sectoriels des régulateurs existants | ICO |
| États-Unis (pour comparer) | Pas de loi fédérale ; lois d'État comme le CCPA californien (2020) | Pas de loi fédérale ; lignes directrices et procès | FTC, procureurs des États |
Trois modèles coexistent dans le monde : l'Europe régule par la loi, les États-Unis par le marché et les procès, la Chine par l'État, et la CNIL tient une carte des lois de protection des données pays par pays.
La Chine a sa loi sur les données personnelles, la PIPL, en vigueur depuis le 1er novembre 2021 : sur le papier elle ressemble beaucoup au RGPD (consentement, minimisation, droits), mais le régulateur, l'Administration du cyberespace, répond au pouvoir politique et non à un juge indépendant.
Elle sanctionne fort : en juillet 2022, la plateforme de VTC DiDi a reçu une amende de 8,026 milliards de yuans (environ 1,2 milliard de dollars), un an après s'être introduite en bourse à New York malgré les réserves de Pékin.
Sur l'IA, la Chine a été la première à réglementer l'IA générative, dès le 15 août 2023, avec une exigence que l'Europe n'a pas : les contenus doivent respecter les « valeurs socialistes fondamentales ».
Depuis le 1er septembre 2025, tout texte, image, son ou vidéo généré par IA et diffusé sur une plateforme chinoise doit porter une mention visible et une marque dans les métadonnées, un an avant l'obligation européenne équivalente.
L'Inde a adopté son DPDP Act en août 2023, mais les règles d'application n'ont été publiées que le 14 novembre 2025, avec une mise en œuvre étalée jusqu'en mai 2027 et des amendes qui peuvent atteindre 250 crores de roupies, soit environ 25 millions d'euros.
Pour une marque qui vend en Inde, la contrainte la plus concrète est que la loi impose que la demande de consentement soit présentée en anglais ou dans l'une des vingt-deux langues inscrites dans la Constitution indienne.
Le Brésil a copié le RGPD avec sa LGPD de 2018, appliquée depuis septembre 2020 par l'ANPD, et il copie maintenant l'AI Act avec le projet de loi 2338/2023, classement par niveau de risque compris, voté au Sénat le 10 décembre 2024 et encore devant la Chambre des députés en 2026.
Le Royaume-Uni a gardé le RGPD après le Brexit sous le nom d'UK GDPR, l'a légèrement assoupli avec le Data (Use and Access) Act de juin 2025, et refuse pour l'instant toute loi générale sur l'IA : chaque régulateur existant, dont l'ICO, publie ses propres guides.
Pour une campagne internationale, la conséquence est pratique : un chatbot déployé en Chine doit afficher son étiquette, une base clients indienne exige un consentement multilingue, et le marché britannique se traite presque comme un marché européen.
Le RGPD est ainsi devenu le modèle copié à Brasília, à New Delhi et même, dans la forme, à Pékin, mais c'est l'application qui distingue les régimes : une autorité indépendante d'un côté, un ministère de l'autre.
Droit d'auteur et données d'entraînement : les procès en cours
| Affaire | Pays | Où en est-on (septembre 2026) |
|---|---|---|
| New York Times c. OpenAI et Microsoft | États-Unis | Plainte du 27 décembre 2023 ; en septembre 2026, le ministère américain de la Justice a pris position pour OpenAI ; aucune date de procès fixée |
| Bartz c. Anthropic | États-Unis | Juin 2025 : entraîner un modèle sur des livres achetés est un usage loyal, les télécharger sur un site pirate ne l'est pas ; accord de 1,5 milliard de dollars approuvé le 20 juillet 2026 |
| GEMA c. OpenAI | Allemagne | 11 novembre 2025 : le tribunal de Munich juge que mémoriser des paroles de chansons est une reproduction illicite ; OpenAI condamné |
| Getty Images c. Stability AI | Royaume-Uni | 4 novembre 2025 : Getty perd l'essentiel, l'entraînement ayant eu lieu hors du Royaume-Uni |
| SNE, SGDL et SNAC c. Meta | France | Assignation de mars 2025 devant le tribunal judiciaire de Paris, en cours |
Un grand modèle de langage a « lu » des milliards de pages web, de livres, d'images et de chansons, dont une bonne part est protégée par le droit d'auteur, et la question qui occupe les tribunaux depuis 2023 est simple : cette lecture est-elle une copie qui exigeait une autorisation ?
Aux États-Unis, la réponse passe par le « fair use » : en juin 2025, dans Bartz c. Anthropic, un juge a estimé qu'entraîner un modèle sur des livres légalement achetés était un usage loyal, mais que constituer une bibliothèque à partir de sites pirates ne l'était pas.
Anthropic a préféré payer plutôt que plaider : 1,5 milliard de dollars, environ 3 000 dollars par livre, le plus gros règlement de l'histoire du droit d'auteur américain, approuvé le 20 juillet 2026.
Le procès le plus suivi reste celui du New York Times contre OpenAI et Microsoft : le journal affirme que ChatGPT a été entraîné sur des millions de ses articles et peut les restituer presque mot pour mot, et, en septembre 2026, le ministère américain de la Justice est intervenu pour soutenir OpenAI, sans qu'aucune date de procès soit encore fixée.
En Europe, il n'y a pas de fair use : la directive de 2019 autorise la fouille de textes et de données sauf si l'ayant droit s'y est opposé, et l'AI Act oblige depuis août 2025 les fournisseurs de modèles à respecter ces oppositions et à publier un résumé de leurs données d'entraînement.
Le tribunal de Munich a rendu en novembre 2025 la première condamnation européenne : dans GEMA c. OpenAI, ChatGPT restituait des paroles de chansons allemandes, preuve qu'il les avait mémorisées, ce que le juge a qualifié de reproduction.
À Londres, le même mois, Getty Images a perdu l'essentiel de son procès contre Stability AI, surtout parce que l'entraînement avait eu lieu hors du Royaume-Uni : le lieu de l'entraînement compte autant que le droit.
En France, le Syndicat national de l'édition et les auteurs ont assigné Meta en mars 2025 pour l'entraînement de Llama sur des livres français, et l'affaire est toujours devant le tribunal judiciaire de Paris.
L'autre face du problème vous concerne directement : ce que vous générez est-il protégé ?
Le Bureau américain du droit d'auteur a répondu en janvier 2025 qu'une image produite par un simple prompt n'a pas d'auteur, donc pas de protection, et le droit français, qui exige une œuvre de l'esprit portant l'empreinte d'une personne, va dans le même sens.
Concrètement, le visuel de campagne que vous générez en deux minutes peut être repris par votre concurrent sans que vous puissiez rien dire, sauf si vous démontrez un travail créatif humain (retouches, composition, direction artistique) documenté.
Trois règles de prudence pour un service marketing : vérifier ce que la licence de l'outil garantit (certains éditeurs indemnisent leurs clients professionnels en cas de procès), ne jamais écrire le nom d'un artiste vivant ou d'une marque concurrente dans un prompt, et conserver la trace de l'intervention humaine.
Les acteurs de l'IA
Le privé : sept entreprises, trois pays, des milliards
| Acteur | Siège | Créé en | Financé par | Produit que vous connaissez |
|---|---|---|---|---|
| OpenAI | San Francisco | 2015, comme association à but non lucratif | Microsoft (27 % du capital depuis octobre 2025), puis Amazon, Nvidia et SoftBank : 122 milliards de dollars levés en mars 2026 pour une valorisation de 852 milliards (CNBC) | ChatGPT |
| Anthropic | San Francisco | 2021, par d’anciens d’OpenAI | Amazon et Google (2023), Nvidia et Microsoft (novembre 2025) ; valorisée 965 milliards de dollars en mai 2026 | Claude, Claude Code |
| Google DeepMind | Londres et Mountain View | DeepMind en 2010, racheté par Google en 2014, fusionné avec Google Brain en 2023 | Alphabet, c’est-à-dire la publicité de Google (chiffre d’affaires du groupe en hausse de 24 % au deuxième trimestre 2026, Alphabet) | Gemini |
| Meta | Menlo Park | Laboratoire FAIR en 2013, Meta Superintelligence Labs en juin 2025 | Meta elle-même (publicité de Facebook et Instagram) ; 14,3 milliards de dollars mis dans Scale AI en juin 2025 | Meta AI (dans WhatsApp et Instagram), propulsé depuis juillet 2026 par le modèle Muse Spark ; modèles Llama à poids ouverts |
| Mistral AI | Paris | Avril 2023 | ASML (11 % du capital, septembre 2025), Samsung (3 milliards d’euros, septembre 2026) ; valorisée 21 milliards d’euros | Le Chat (renommé Vibe en mai 2026), modèles ouverts |
| xAI | San Francisco, supercalculateur à Memphis | Juillet 2023, par Elon Musk | Elon Musk et ses investisseurs ; fusion avec X (ex-Twitter) en mars 2025, absorbée par SpaceX en février 2026 | Grok |
| DeepSeek | Hangzhou (Chine) | 2023 | Le fonds spéculatif High-Flyer de son fondateur Liang Wenfeng, sans investisseur extérieur | DeepSeek (modèles publiés sous licence MIT) |
Les sept acteurs privés qui comptent en septembre 2026 — Sources : pages Wikipédia liées dans la première colonne, chiffres datés dans la colonne « Financé par ».
Derrière chaque assistant que vous utilisez, il y a une entreprise, un siège, et surtout un financeur.
Cinq des sept acteurs du tableau sont américains, un est chinois et un seul est européen, Mistral AI, installé à Paris.
Le premier enseignement du tableau, c’est l’ordre de grandeur de l’argent : OpenAI a levé 122 milliards de dollars en une seule fois en mars 2026, un record absolu pour une entreprise non cotée selon CNBC.
Le deuxième, c’est que les financeurs sont souvent les mêmes : Microsoft, Amazon, Google et Nvidia investissent dans OpenAI et dans Anthropic, puis leur vendent la puissance de calcul que cet argent sert à acheter.
Anthropic s’est ainsi engagée en novembre 2025 à acheter pour environ 30 milliards de dollars de capacités de calcul chez Microsoft, le jour même où Microsoft annonçait investir 5 milliards chez elle.
Google et Meta n’ont pas ce problème : leurs modèles sont payés par la publicité, qui reste le premier métier des deux groupes.
Meta a longtemps choisi une autre voie en publiant les poids de ses modèles Llama, ce que l’Open Source Initiative refuse d’appeler open source, la licence restreignant certains usages.
Depuis juillet 2026, le modèle qui fait tourner Meta AI, Muse Spark, n’est plus publié ; seul un petit modèle, Muse Glimmer, l’a été en août 2026.
DeepSeek est le cas à part : financé par un fonds spéculatif et non par la Silicon Valley, il a publié en janvier 2025 un modèle de raisonnement, R1, comparable à ceux d’OpenAI, ce qui a fait perdre 600 milliards de dollars de valeur boursière à Nvidia en une séance.
L’entreprise annonçait 5,57 millions de dollars pour un seul cycle d’entraînement de son modèle V3, un chiffre contesté car il exclut les salaires et le matériel : les 2 048 cartes Nvidia H800 utilisées valaient à elles seules environ 70 millions de dollars.
xAI illustre la fragilité de ces structures : neuf des onze cofondateurs qui entouraient Elon Musk étaient partis au printemps 2026, et la société a été absorbée par SpaceX le 2 février 2026 pour préparer une entrée en bourse.
Pour un futur gestionnaire, la question à se poser devant ces chiffres est simple : combien ces entreprises gagnent-elles, et quand ?
OpenAI prévoit 25 milliards de dollars de chiffre d’affaires en 2026 pour une valorisation de 852 milliards, soit 34 années de ventes, ce que certains analystes comparent à la bulle internet de 2000.
Le public et l’open source : de quatre outils à un seul
| Outil | C’est quoi | En 2023, il fallait… | En 2026 |
|---|---|---|---|
| Hugging Face | Le dépôt public des modèles (1,3 million de modèles hébergés en 2024) | Chercher le bon modèle, comprendre sa licence, télécharger des fichiers de plusieurs gigaoctets | Toujours la bibliothèque de référence, mais on n’y passe plus pour un usage courant |
| Transformers | La bibliothèque Python qui charge et fait tourner un modèle | Installer Python, PyTorch, les pilotes de carte graphique, puis écrire du code | Réservé à ceux qui développent ou entraînent des modèles |
| LangChain | Un cadre logiciel (octobre 2022) pour enchaîner les appels à un modèle | Coder chaque étape : lire un document, interroger le modèle, garder la mémoire de la conversation | Remplacé, pour l’usager, par les agents prêts à l’emploi |
| GitHub | L’hébergeur de code (100 millions d’inscrits en 2023, propriété de Microsoft) | Cloner des dépôts, suivre des instructions d’installation souvent périmées | Toujours là, mais l’agent s’en sert à votre place |
| Ollama | Un logiciel libre (juillet 2023) qui télécharge et fait tourner un modèle en une commande | Un outil parmi les autres, limité au dialogue dans le terminal | L’outil unique : il lance le modèle et le branche sur un agent |
La chaîne d’outils de l’IA ouverte, hier et aujourd’hui — Sources : sites officiels liés, chiffres Wikipédia (Hugging Face, GitHub, Ollama).
Face aux entreprises du tableau précédent, il existe un monde de modèles ouverts, que n’importe qui peut télécharger et faire tourner sur son ordinateur, sans compte ni abonnement.
Ces modèles viennent de Meta (Llama), de Mistral, de DeepSeek, d’Alibaba (Qwen), de Google (Gemma) ou de laboratoires publics, et ils sont déposés sur Hugging Face, une entreprise américaine fondée par trois Français, qui joue le rôle de bibliothèque.
Quand j’ai commencé à les utiliser en 2023, il fallait jongler avec quatre outils : Hugging Face pour trouver le modèle, Transformers pour le charger, LangChain pour enchaîner les étapes et GitHub pour récupérer le code des autres.
Chaque étape cassait pour une raison différente, une version de Python, un pilote de carte graphique, une bibliothèque renommée entre-temps.
En 2026, un seul outil suffit : Ollama, un logiciel libre qui télécharge un modèle et le fait tourner en une ligne.
terminalollama run gemma4
Le vrai changement, c’est qu’Ollama sait désormais brancher ce modèle sur un agent, c’est-à-dire un programme qui agit à votre place, avec la commande ollama launch claude, documentée par Ollama.
terminalollama launch claude
Cette commande ouvre Claude Code, l’agent d’Anthropic, mais en le faisant tourner sur le modèle ouvert de votre choix, sur votre machine, où restent vos données.
La même documentation propose ollama launch opencode, qui lance OpenCode, un agent entièrement open source, et la liste complète comprend aussi Codex (OpenAI), Droid (Factory) et VS Code.
Deux autres agents méritent d’être connus : Gemini CLI, que Google publie en open source avec un usage gratuit sur simple compte Google, et Codex CLI, l’équivalent chez OpenAI.
Ollama précise qu’un agent a besoin d’un modèle avec une mémoire de travail d’au moins 64 000 jetons, ce qui demande un ordinateur récent, et propose sinon des modèles hébergés dans son cloud.
Nous ferons l’installation ensemble dans le chapitre suivant ; retenez ici que la barrière technique de 2023 a disparu.
Le modèle ne suffit pas : ce qui compte, c’est l’écosystème autour
Un modèle seul, c’est une boîte qui reçoit du texte et renvoie du texte : il ne voit ni vos fichiers, ni le web, ni la date du jour.
Ce qui fait la valeur d’une IA en 2026, c’est tout ce qui entoure cette boîte, et c’est ce que le schéma appelle l’agent.
La première capacité qui compte est de raisonner, c’est-à-dire de découper une tâche en étapes avant de répondre, ce que les modèles font depuis fin 2024 en écrivant leur brouillon avant la réponse.
La deuxième est de ne pas halluciner, et le chapitre sur l’enjeu du moment vous a montré que le modèle seul en est incapable ; l’agent, lui, peut aller vérifier.
Demandez à un chatbot le chiffre d’affaires 2025 de Michelin : il vous donnera un nombre plausible ; demandez-le à un agent, il ouvrira le rapport annuel sur le site de Michelin et vous citera la page.
La troisième est de garder le cap sur l’objectif du prompt pendant des dizaines d’étapes sans se perdre, ce qui distingue un bon agent d’un mauvais bien plus que le modèle qu’il utilise.
Viennent ensuite les outils : faire des requêtes internet, ouvrir un site précis, lire et écrire des fichiers sur votre disque, lancer une commande dans le terminal.
Le standard qui permet de brancher d’autres outils, votre agenda, vos mails ou une base de données, s’appelle MCP, vu au chapitre sur l’enjeu du moment.
C’est pour cela que je vous recommande Claude Code même avec un modèle open source : la boucle de travail, la gestion des fichiers, la vérification des résultats sont dans l’agent, pas dans le modèle.
Le même modèle Qwen lancé dans le terminal d’Ollama et lancé dans Claude Code ne donne pas la même chose : dans le premier cas il discute, dans le second il construit un site.
Claude Code n’est pas open source, mais il est gratuit à installer et s’adapte au modèle qu’on lui donne ; OpenCode fait la même chose en logiciel libre, avec un peu moins de finition.
Pour un marketeur, la conclusion est pratique : ne choisissez pas une IA sur le nom de son modèle, choisissez-la sur ce qu’elle sait faire dans votre environnement de travail.
Les plus performants restent privés : benchmarks crédibles ou foutaises ?
Un benchmark est un examen standardisé que l’on fait passer aux modèles pour les comparer, et chaque éditeur publie ses scores le jour de la sortie d’un modèle.
Le plus ancien, MMLU (2020), est un QCM de 15 908 questions dans 57 matières ; les experts humains y font environ 89,8 %, et les meilleurs modèles atteignent 88 % depuis mi-2024, ce qui l’a rendu inutile pour les départager.
Une analyse de juin 2024 a d’ailleurs trouvé des erreurs dans 6,5 % de ses questions, jusqu’à 57 % en virologie : on mesurait aussi la capacité à reproduire des corrigés faux.
SWE-bench Verified est plus sérieux : 500 bugs réels tirés de dépôts GitHub, que le modèle doit corriger en modifiant le code jusqu’à ce que les tests passent.
Le graphique montre le score des modèles Claude passer de 33 % à 81 % en vingt mois, mais lisez la légende : ces chiffres sont déclarés par Anthropic, sur son propre montage, avec ses propres réglages.
Arena, né à Berkeley en avril 2023 sous le nom de Chatbot Arena puis appelé LMArena jusqu’en janvier 2026, évite ce biais en faisant voter le public entre deux réponses anonymes, ce qui produit un classement du type Elo des échecs.
Mais une étude de 2025, The Leaderboard Illusion, a mesuré que Meta avait testé 27 variantes privées avant de publier Llama 4, ne gardant que la mieux classée.
La même étude chiffre que Google et OpenAI ont reçu respectivement 19,2 % et 20,4 % des données de l’arène, contre 29,7 % pour 83 modèles ouverts réunis, un accès qui peut améliorer le score jusqu’à 112 %.
Reste le problème de fond, la contamination : les questions des examens circulent sur internet, donc dans les données d’entraînement, et le modèle a parfois déjà vu le sujet.
Des chercheurs ont écrit des problèmes d’arithmétique inédits, GSM1k, et ont mesuré des baisses allant jusqu’à 8 points chez certaines familles de modèles qui avaient appris l’examen par cœur.
Ni crédibles ni foutaises, donc : les benchmarks disent la tendance, et la tendance est nette, mais la décimale qui sépare deux modèles ne veut rien dire.
Au 14 septembre 2026, les dix premières places du classement texte d’Arena sont toutes occupées par des modèles privés, sept versions de Claude, deux de Muse Spark (Meta) et une de Gemini ; dans le classement dédié au code web, GPT-6 est premier et les chinois Qwen et Kimi entrent dans les cinq premiers.
Le seul benchmark qui vaut pour vous est votre tâche : le même prompt, collé dans deux ou trois assistants, et vous jugez.
Les principaux : ChatGPT, Claude, Gemini et l’IA d’Apple
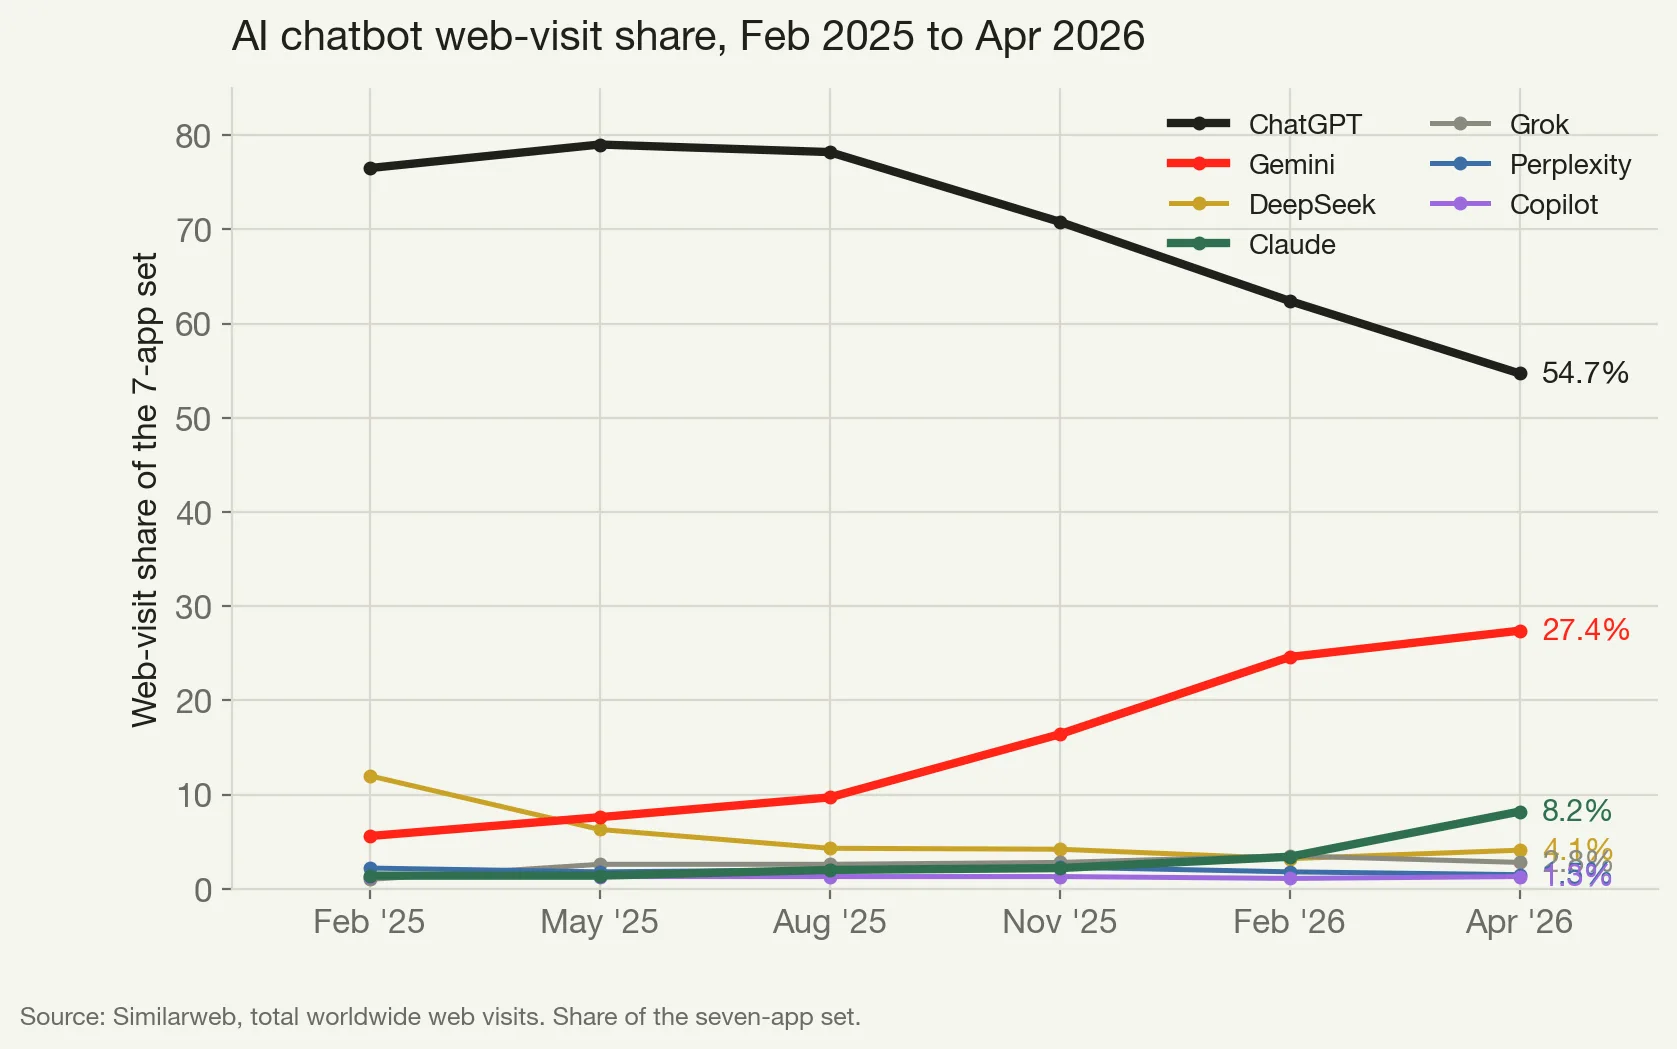
Le graphique compte les visites des sites web des sept principaux assistants, et il raconte en un coup d’œil l’année écoulée.
ChatGPT reste largement premier avec 54,7 % des visites en avril 2026 et 900 millions d’utilisateurs hebdomadaires revendiqués en février 2026, mais sa part a perdu 24 points depuis mai 2025, où elle frôlait 79 %.
Gemini est celui qui monte : de 6 % en février 2025 à 27,4 % en avril 2026, et Google annonce 950 millions d’utilisateurs mensuels pour son application en juillet 2026.
Claude décolle tard mais vite : entre 1,5 et 3 % pendant toute l’année 2025, puis 8,2 % en avril 2026, la courbe se redressant nettement entre février et avril.
L’explication tient en partie à l’actualité : fin février 2026, le refus d’Anthropic d’accorder au Pentagone un usage sans restriction de Claude a propulsé l’application en tête de l’App Store américain.
DeepSeek fait le chemin inverse : 12 % en février 2025, au plus fort de la vague R1, puis 4,1 % un an plus tard, l’effet de curiosité passé.
Grok, Perplexity et Copilot se partagent le reste, entre 1,5 et 3 % chacun, alors que Copilot est pourtant installé dans chaque Windows.
L’IA d’Apple n’apparaît pas sur le graphique, parce qu’Apple n’a pas de chatbot : Apple Intelligence, lancé en octobre 2024 et disponible en français depuis mars 2025, est un ensemble de fonctions dans l’iPhone.
Pour les questions difficiles, Siri passe la main à ChatGPT depuis décembre 2024, et depuis un accord de janvier 2026, la nouvelle Siri repose sur une version de Gemini, qu’Apple paierait environ un milliard de dollars par an.
Le fabricant de l’iPhone achète donc son intelligence à ses deux concurrents, ce qui en dit long sur le coût d’entrée dans cette course.
Retenez aussi ce que ce graphique ne mesure pas : les applications mobiles, les assistants intégrés dans WhatsApp, dans Windows ou dans Google, et les usages professionnels par API, qui est précisément là où Claude gagne sa vie.
C’est justement ce que le titre suivant essaie d’expliquer.
Pourquoi ces écarts ?
La première réponse est la distribution, une notion que nous retrouverons à la séance sur le mix marketing : le meilleur produit ne gagne pas, celui qui est déjà là où vous êtes gagne.
Android équipe 67,6 % des téléphones du monde en août 2026, et Gemini y est préinstallé, dans Chrome, dans Gmail et dans les résultats de recherche Google.
Apple équipe les 32 % restants, et c’est pourquoi l’accord Siri-Gemini de janvier 2026 vaut plus pour Google que n’importe quelle campagne de publicité.
Meta AI est l’exemple le plus frappant : un milliard d’utilisateurs mensuels annoncés en mai 2025, sans que personne n’ait choisi d’y aller, parce que l’assistant est dans la barre de recherche de WhatsApp et d’Instagram.
Copilot est dans chaque Windows et chaque Office, et pourtant sa part de visites web reste autour de 1,5 % : la distribution donne l’accès, elle ne garantit pas l’usage.
La deuxième réponse est la gratuité : tous ces assistants ont une version gratuite, et sur les 900 millions d’utilisateurs hebdomadaires de ChatGPT, 50 millions seulement paient un abonnement, soit un peu plus de 5 %.
Un modèle économique où près de 95 % des clients ne paient pas explique les levées de fonds du premier titre, et pose la question du jour où il faudra rentabiliser.
La troisième réponse est l’intégration aux outils existants : Gemini écrit dans Google Docs, Copilot dans Word, Claude dans le terminal et dans les logiciels des développeurs.
Chacun s’installe dans les outils que ses clients ouvrent déjà, ce qui explique que les courbes ne se ressemblent pas selon qu’on mesure des visites web, des utilisateurs d’application ou des revenus.
Claude, avec 8,2 % des visites web, réalisait déjà un milliard de dollars de chiffre d’affaires annualisé avec le seul Claude Code en décembre 2025 : son public est plus étroit, mais il paie.
ChatGPT, lui, a bénéficié d’un avantage que le marketing appelle la prime au premier entrant : en novembre 2022, il était seul, et le nom est devenu le nom commun de la catégorie, comme Frigidaire ou Kleenex.
Sa part recule non parce qu’il est devenu mauvais, mais parce que les concurrents ont rattrapé le modèle et qu’ils disposent de canaux de distribution qu’OpenAI n’a pas.
D’où le rachat par OpenAI, en mai 2025 et pour 6,5 milliards de dollars, de la société de Jony Ive, l’ancien designer de l’iPhone : sans téléphone ni système d’exploitation, il lui faut inventer son propre canal.
Je vous guide
IA sur votre PC ou dans le cloud
Quand vous tapez une question dans ChatGPT ou Claude, le calcul ne se fait pas sur votre machine : votre texte part sur Internet vers un centre de données, des milliers de serveurs qui exécutent le modèle et vous renvoient la réponse.
C'est ce qu'on appelle le cloud, autrement dit l'ordinateur de quelqu'un d'autre, loué à la demande.
Le site de démonstration que je publie chez Hostinger repose sur le même principe : mes fichiers sont copiés sur une machine louée, allumée en permanence, et c'est elle que vos navigateurs interrogent, pas mon Mac.
L'autre option est de faire tourner le modèle sur votre propre ordinateur, ce que permet Ollama, un logiciel gratuit qui télécharge un modèle ouvert et l'exécute sans connexion.
Trois choses changent selon l'option choisie : ce que ça coûte, ce qui sort de votre machine, et la puissance disponible.
Côté coût, le cloud se paie à l'abonnement : Claude est gratuit avec des limites, et la formule Pro, la première qui inclut Claude Code, est facturée 20 dollars par mois (17 dollars en paiement annuel) en septembre 2026 ; en local, le modèle est gratuit, mais c'est votre matériel qui paie, en mémoire vive surtout.
Un modèle ouvert récent comme gpt-oss 20B demande au moins 16 Go de mémoire vive, alors que gemma3 4B se télécharge en 3,3 Go et tourne sur un portable ordinaire, au prix d'une qualité nettement plus faible.
Côté données, tout ce que vous collez dans un service en ligne quitte votre machine : un brief client, un fichier de ventes ou une liste de prospects partent chez un prestataire, le plus souvent américain, ce qui pose les questions que la CNIL détaille dans ses fiches pratiques sur l'IA.
En local, rien ne sort : c'est l'argument des entreprises qui manipulent des données sensibles et choisissent Ollama malgré des modèles moins performants.
Côté puissance, le cloud gagne sans discussion : les modèles les plus capables de 2026 ne tiennent sur aucun ordinateur personnel.
Retenez la règle simple : données banales ou publiques, le cloud est plus commode ; données personnelles ou confidentielles, on réfléchit avant de coller.
La démo de cette séance tourne sur Claude dans le cloud, parce que je paie l'abonnement, mais la même séquence fonctionne en local avec Ollama, et je vous invite à comparer les deux.
IA open source ou IA privée : laquelle installer
| Outil | Modèle | Où il tourne | Prix (septembre 2026) | Site officiel |
|---|---|---|---|---|
| Claude et Claude Code | privé (Anthropic) | cloud | gratuit avec limites ; Pro 20 $ par mois, Claude Code inclus | claude.com |
| ChatGPT | privé (OpenAI) | cloud | gratuit avec limites ; formules payantes | chatgpt.com |
Ollama, puis ollama launch claude | ouvert (gpt-oss, gemma3, qwen3, etc.) | votre ordinateur | gratuit ; 16 Go de mémoire conseillés | ollama.com |
| OpenCode | au choix, ouvert ou privé | votre ordinateur ou le cloud | gratuit (le modèle en ligne peut être payant) | opencode.ai |
Le chapitre précédent a posé le débat entre modèles ouverts et modèles privés ; ici, on choisit ce qu'on installe.
Un modèle privé, comme ceux de Claude ou de ChatGPT, n'est accessible qu'à travers le service de son éditeur, qui garde le modèle pour lui et vous en vend l'usage.
Un modèle ouvert est publié avec ses poids, c'est-à-dire le fichier qui contient tout ce qu'il a appris, et n'importe qui peut le télécharger, l'exécuter et le modifier.
En 2026, les modèles ouverts les plus utilisés viennent de Google, de Meta, de Mistral, d'OpenAI avec gpt-oss, et de laboratoires chinois comme Qwen ou DeepSeek, tous disponibles dans la bibliothèque d'Ollama.
Le modèle ne fait pas tout : il faut un outil qui le fasse travailler sur vos fichiers, et c'est là que se joue la différence.
Je vous montre la démo avec Claude Code, l'outil en ligne de commande d'Anthropic, parce que c'est la référence en 2026 et que Claude et GPT restent les modèles les plus performants.
Deux alternatives gratuites existent, avec une bonne nouvelle : la commande ollama launch claude lance Claude Code lui-même, mais branché sur un modèle ouvert qui tourne sur votre machine, comme l'explique la documentation d'Ollama.
La seconde est OpenCode, un agent entièrement ouvert qui accepte n'importe quel modèle, local ou en ligne.
Pour un étudiant qui veut essayer sans payer, Ollama suffit, et si le résultat déçoit, le passage à Claude Pro se fait en cinq minutes.
Le test honnête consiste à donner le même prompt aux deux et à comparer les résultats : c'est exactement ce que je vous propose de faire avec le projet de fin de chapitre.
L'IA agentique : une IA qui agit sur votre ordinateur
Un chat classique produit du texte : vous posez une question, il répond, et c'est à vous de copier, de coller, de créer les fichiers et d'exécuter.
Un agent fait l'inverse : il reçoit un objectif, puis il lit, écrit et exécute lui-même, en boucle, jusqu'à ce que le résultat soit là.
Concrètement, Claude Code lancé dans un dossier peut ouvrir vos fichiers, créer un site, lancer un script Python, lire le message d'erreur, corriger et relancer, comme le décrit sa documentation officielle.
Anthropic distingue les flux de travail, où l'humain fixe chaque étape à l'avance, des agents, où le modèle décide lui-même de l'étape suivante ; sa note « Building effective agents » (décembre 2024) reste la référence la plus lisible.
Pour un gestionnaire, la différence est énorme : un agent ne vous donne pas la recette, il fait le plat, et vous jugez le plat.
« Lis ce fichier de ventes, calcule le panier moyen par mois et fais-moi un graphique » est une tâche d'agent, pas une question de chat.
C'est aussi ce qui rend la chose sérieuse : un agent qui écrit et exécute peut effacer un fichier ou envoyer un mail, donc Claude Code vous demande la permission avant chaque action qui modifie quelque chose.
Lisez ces demandes, au moins les premières fois, et travaillez dans un dossier dédié plutôt qu'à la racine de vos documents.
Le mode d'emploi tient en trois gestes : ouvrir un terminal dans un dossier, taper claude, et écrire ce que vous voulez en français.
Le terminal fait peur au premier abord ; le guide de Terminal d'Apple ou l'application Terminal de Windows suffisent, et l'agent lui-même vous expliquera n'importe quelle commande si vous le lui demandez.
C'est le sens de ce que j'appelais plus haut la révolution de 2026 : la valeur ne sera plus de savoir coder, mais de savoir dire à un agent quoi faire, vérifier ce qu'il a fait, et décider.
L'art du prompting : trompez-vous et apprenez en faisant
| Principe | Ce qu'on oublie la première fois | Ce qu'on écrit |
|---|---|---|
| 1. Le contexte | qui vous êtes, ce que vous avez sous la main, à quoi servira le résultat | « Je suis étudiant en L2, je ne sais pas programmer, ce dossier contient l'export de ma playlist. » |
| 2. Le résultat attendu | la forme, les contraintes, le critère de réussite | « Un seul dossier, aucune installation, ça doit s'ouvrir en double-cliquant, vérifie que tous les titres s'affichent. » |
| 3. L'itération | que le premier essai est rarement le bon | « Le tri par date ne marche pas, voici le message d'erreur, corrige. » |
Le prompt est la consigne que vous donnez à l'IA, et sa qualité fait l'essentiel du résultat.
Il n'y a pas de formule magique, mais trois principes simples qui reviennent dans tous les guides, dont ceux d'Anthropic et d'OpenAI.
Premier principe, le contexte : dites qui vous êtes, ce que vous avez sous la main et à quoi servira le résultat, car l'IA ne devine rien de ce qui est dans votre tête.
Deuxième principe, le résultat attendu : décrivez la forme (un fichier, un tableau, dix lignes), les contraintes (en français, sans installation, pour un débutant) et ce qui permettra de dire que c'est réussi.
Troisième principe, l'itération : le premier résultat est rarement le bon, et c'est normal ; on lit, on dit ce qui ne va pas, on relance.
Voici un mauvais prompt, celui que tout le monde écrit la première fois.
promptFais-moi un lecteur de musique.
L'IA va choisir à votre place le langage, le format et les fonctions, et vous rendra quelque chose qui n'est pas ce que vous vouliez, sans que ce soit sa faute.
Voici le même besoin, écrit avec les trois principes.
promptJe suis étudiant en L2 Gestion et je ne sais pas programmer. Dans ce dossier se trouve Liked_Songs.csv, l'export de ma playlist Spotify. Construis un site web local qui liste mes titres avec une recherche par artiste. Contraintes : un seul dossier, aucune installation, le site doit s'ouvrir en double-cliquant sur index.html. Quand tu as fini, vérifie que le nombre de titres affichés est égal au nombre de lignes du CSV, et dis-moi ce que tu as vérifié.
Le second est plus long, mais chaque phrase enlève une décision à l'IA et une mauvaise surprise à vous.
Ma consigne pour la suite du cours est de vous tromper : lancez un prompt médiocre, regardez ce qui sort, puis reformulez, parce que c'est en comparant les deux résultats qu'on apprend à écrire le bon.
Gardez une trace de vos prompts qui ont marché dans un fichier texte : c'est votre première boîte à outils de marketeur en 2026.
Installer les outils en cinq minutes
| Ce que vous voulez | Ce qu'il faut | La commande | Mode d'emploi officiel |
|---|---|---|---|
| La démo telle quelle (Claude Code) | un compte Claude Pro, un terminal | curl -fsSL https://claude.ai/install.sh | bash (Mac) ; irm https://claude.ai/install.ps1 | iex (Windows) | code.claude.com |
| La même chose, gratuite et locale | Ollama installé, 16 Go de mémoire conseillés | ollama launch claude | docs.ollama.com |
| Un agent entièrement ouvert | un terminal, puis un modèle au choix | curl -fsSL https://opencode.ai/install | bash | opencode.ai |
| Votre playlist en CSV | un compte Spotify | bouton Export sur le site | exportify.net |
Avant la démo, voici ce qu'il faut installer, une seule fois, sur un Mac ou un PC ; comptez cinq minutes et une connexion correcte.
Option payante, celle de la démo : créez un compte sur claude.com, prenez la formule Pro, qui est la première à inclure Claude Code, puis installez l'outil en collant dans le Terminal la commande donnée sur la page d'installation.
terminalcurl -fsSL https://claude.ai/install.sh | bash
Sur Windows, la même chose se fait dans PowerShell.
terminalirm https://claude.ai/install.ps1 | iex
Option gratuite : téléchargez Ollama, lancez-le, puis tapez la commande qui démarre Claude Code branché sur un modèle ouvert ; si elle vous signale que Claude Code manque, installez-le d'abord avec la commande ci-dessus, ce qui ne demande aucun abonnement.
terminalollama launch claude
Ollama vous propose alors un modèle ; sur un portable avec 8 Go de mémoire, prenez un petit modèle comme gemma3 4B, et avec 16 Go ou plus, gpt-oss 20B ou qwen3 donnent des résultats nettement meilleurs.
Attention, Ollama propose aussi des modèles dits « cloud », qui tournent sur ses propres serveurs : ils sont plus puissants, mais vos données quittent alors la machine, comme avec Claude.
Troisième voie, tout aussi gratuite, OpenCode s'installe d'une commande et se configure ensuite avec le modèle de votre choix, local ou en ligne.
terminalcurl -fsSL https://opencode.ai/install | bash
Dans tous les cas, la première utilisation demande de se connecter ou de choisir un modèle, et l'outil vous guide.
Enfin, préparez votre export Spotify sur Exportify : cliquez sur « Get Started », connectez-vous avec votre compte Spotify, autorisez la lecture seule de vos playlists, et cliquez sur « Export » en face de la playlist choisie, ou de vos titres likés, pour récupérer un fichier CSV.
Si vous n'avez pas Spotify, n'importe quel tableau de titres (artiste, titre, album, durée) exporté depuis Deezer ou Apple Music, ou tapé à la main dans un tableur, fera l'affaire, du moment qu'il est enregistré en CSV.
Le projet démo, version facile : reconstruire Mélodie
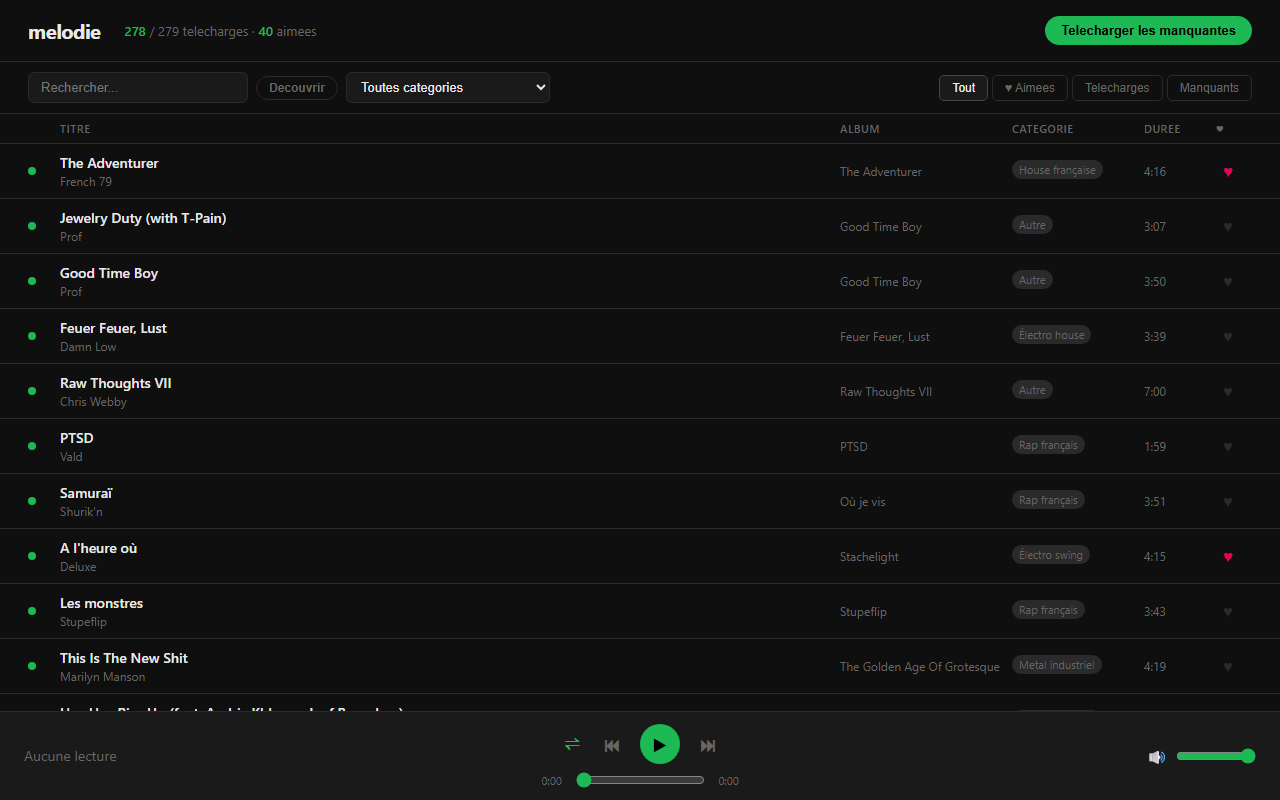
Mélodie est le lecteur de musique que j'utilise chez moi, construit avec Claude Code à partir d'un seul fichier, l'export CSV de mes titres aimés sur Spotify.
Il tourne sur mon PC Windows sans abonnement à un service de streaming : un petit serveur Python, une base de données locale, un dossier de 280 fichiers audio, une page web qui liste 279 titres avec recherche, filtre par catégorie, onglet des titres aimés et lecture aléatoire, et un fichier melodie.exe à double-cliquer qui lance tout et ouvre le navigateur.
Le CSV vient d'Exportify et contient, pour chaque titre, 24 colonnes : identifiant Spotify, titre, album, artistes, date de sortie, durée en millisecondes, genres, label, et même des mesures comme la dansabilité ou le tempo.
| Track URI | Track Name | Artist Name(s) | Album Name | Duration (ms) | Genres |
|---|---|---|---|---|---|
| spotify:track:7ye7Qoj5… | The Adventurer | French 79 | The Adventurer | 256000 | house française |
| spotify:track:6OXc6JDb… | Jewelry Duty (with T-Pain) | Prof;T-Pain | Good Time Boy | 187129 | |
| spotify:track:49u9ZoIJ… | Feuer Feuer, Lust | Damn Low;NOYSE | Feuer Feuer, Lust | 219000 | électro house, hypertechno, hard techno |
La version facile que nous allons reconstruire garde l'essentiel, la bibliothèque, la recherche, les favoris et l'écoute, et laisse de côté le téléchargement audio, la découverte et la radio, que je montrerai ensuite comme des modifications demandées en une phrase.
Je la construis en direct sur mon Mac, alors que Mélodie vit sous Windows, avec Claude Code et le modèle Opus, le plus puissant de la gamme Claude, que mon abonnement me permet d'utiliser ; vous pourrez refaire la même chose avec ollama launch claude et juger si le résultat tient la comparaison.
Étape 1 : exportez votre playlist depuis Exportify et enregistrez le fichier CSV dans un nouveau dossier vide, par exemple musique, sur le Bureau.
Étape 2 : ouvrez un terminal dans ce dossier ; sur Mac, un clic droit sur le dossier puis « Nouveau terminal au dossier », sur Windows, un clic droit dans le dossier puis « Ouvrir dans le Terminal ».
Étape 3 : lancez l'agent, claude avec un abonnement ou ollama launch claude avec un modèle local, et attendez l'invite.
Étape 4 : copiez le prompt ci-dessous, tel quel, collez-le dans l'agent et validez ; il est le même pour toute la promotion, pour que nous comparions des résultats comparables.
promptJe suis dans un dossier qui contient un seul fichier, Liked_Songs.csv : l'export d'une playlist Spotify réalisé avec Exportify (colonnes Track URI, Track Name, Album Name, Artist Name(s), Release Date, Duration (ms), Added At, Genres, entre autres ; les artistes sont séparés par des points-virgules).

Construis dans ce dossier un site web local et statique qui me sert de bibliothèque musicale, dans l'esprit de Spotify mais épuré. Contraintes :

1. Aucun serveur, aucune installation, aucune dépendance : le site doit fonctionner en double-cliquant sur index.html. Comme un navigateur refuse de lire un CSV depuis un fichier local, écris un petit script Python convertir.py qui transforme le CSV en donnees.js (une variable JavaScript contenant la liste des titres), exécute-le toi-même, et ne recopie jamais les données à la main.

2. Fichiers attendus, et rien d'autre : index.html, style.css, app.js, donnees.js, convertir.py, Lancer.command (Mac, rendu exécutable) et Lancer.bat (Windows), qui ouvrent index.html dans le navigateur par défaut, et un README.md de dix lignes qui explique comment relancer la conversion si le CSV change.

3. Fonctions, par ordre de priorité : la liste de tous les titres (titre, artiste principal, album, durée au format m:ss, genre principal) ; une recherche instantanée sur titre, artiste et album ; un filtre par genre ; un tri par date d'ajout, le plus récent en premier par défaut ; un bouton cœur qui marque un titre comme aimé, avec un onglet « Aimés », mémorisé dans le navigateur (localStorage) ; en haut de page, le nombre de titres et la durée totale de la bibliothèque.

4. Pour l'écoute : un clic sur un titre affiche, dans un panneau en bas de page, le lecteur intégré de Spotify du morceau (https://open.spotify.com/embed/track/ID, où ID est la fin du Track URI). Pas de téléchargement de musique.

5. Interface sobre, fond sombre, lisible sur un écran de portable, en français, sans framework ni bibliothèque externe ni CDN, avec un code commenté brièvement.

6. Avant de me rendre la main : exécute convertir.py, vérifie que donnees.js contient exactement autant de titres que le CSV a de lignes, que index.html référence bien style.css, donnees.js et app.js, et que les fichiers de lancement ouvrent index.html. Si quelque chose échoue, corrige et reteste. Ça doit marcher du premier coup quand je double-clique.
Étape 5 : pendant deux à cinq minutes, l'agent lit le CSV, écrit les fichiers, exécute la conversion et vous demande parfois une permission ; répondez oui aux actions dans le dossier, et lisez ce qu'il raconte.
Étape 6 : quand il rend la main, ouvrez le dossier et double-cliquez sur Lancer.command (ou Lancer.bat) : le site s'ouvre dans votre navigateur avec votre bibliothèque, et il doit marcher du premier coup.
Étape 7 : si ce n'est pas le cas, ne cherchez pas la panne vous-même, décrivez-la à l'agent en collant le message d'erreur, et laissez-le corriger ; c'est le troisième principe du prompting en action.
Étape 8 : demandez ensuite une modification en une phrase, un tri par artiste, un thème clair, une colonne avec l'année, et regardez le temps qu'il lui faut ; c'est là que vous comprendrez ce que ça change pour un marketeur qui a besoin d'un outil ce soir et pas dans trois mois.
A vous de jouer
Un visuel de marque, puis une vidéo (Gemini, Veo)
Le premier projet ne demande ni installation ni ligne de code : générer un visuel, puis une courte vidéo, pour la marque que vous suivez en fil rouge.
Veo est le modèle de génération vidéo de Google DeepMind, dans sa version 3.1 depuis le 15 octobre 2025, qui produit à partir d'une description écrite quelques secondes d'images avec le son.
Il s'utilise depuis deux consoles : Gemini pour un essai rapide, et Google Flow, un studio qui enchaîne les plans en gardant les mêmes personnages d'une scène à l'autre.
La vidéo se paie en abonnement ou en crédits selon l'offre du moment, alors que la génération d'images avec Nano Banana 2 est accessible avec un compte Gemini gratuit, avec des limites d'usage.
Google propose par ailleurs aux étudiants de 18 ans et plus un an de Google AI Plus sans frais, génération vidéo comprise, valable jusqu'au 31 décembre 2026 à condition d'enregistrer un moyen de paiement.
Commencez donc par l'image, puis passez à la vidéo si votre compte le permet.
Pour un marketeur, l'intérêt est double : produire en une heure ce qui demandait un shooting, et tester dix idées de visuel avant d'en retenir une.
La question de gestionnaire vient ensuite : que coûtait la version traditionnelle, qu'est-ce que la marque perd en cohérence, et faut-il dire que le contenu est généré.
Sur ce dernier point, l'article 50 du règlement européen sur l'IA, applicable depuis le 2 août 2026, impose de marquer les contenus générés par une IA et de signaler les hypertrucages.
Un bon prompt d'image ou de vidéo se structure toujours de la même façon : la scène, l'action, le style, l'ambiance et le format attendu.
Premier pas : ouvrez Gemini et collez ce prompt en remplaçant la marque.
promptCrée un visuel publicitaire au format carré pour [votre marque fil rouge]. Scène : [un lieu réaliste, par exemple une terrasse de café à Clermont-Ferrand en fin d'après-midi]. Le produit est au premier plan, net, sans texte incrusté. Style photo publicitaire premium, lumière chaude, ambiance calme. Propose ensuite deux variantes : une pour Instagram, une pour un affichage 4x3.
Quand l'image vous convient, reprenez les mêmes éléments dans Flow en ajoutant un mouvement de caméra et une action, et vous obtenez votre premier spot.
Comparez le résultat avec une vraie publicité de la marque : ce qui manque est en général le message, pas l'image.
Mon premier site web (GitHub Pages ou Hostinger)
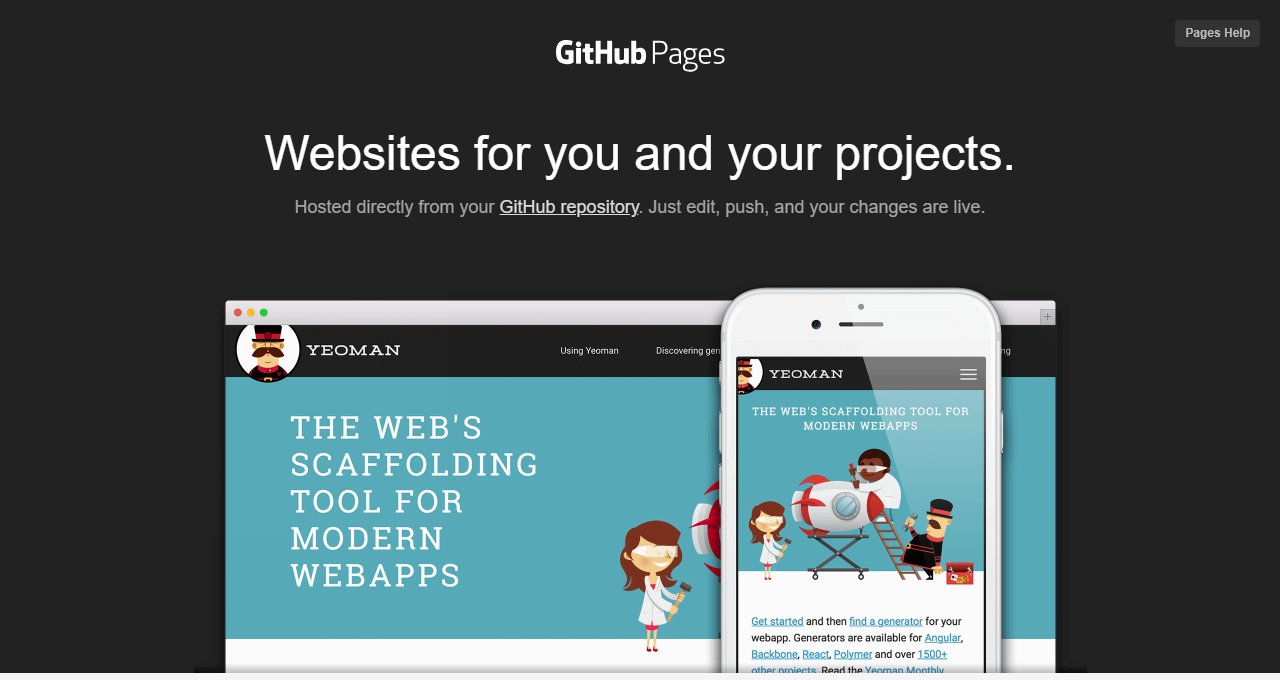
Le chapitre « Comment marche un site web » a montré comment ce site est fabriqué ; ce projet consiste à publier le vôtre.
GitHub Pages héberge gratuitement un site statique directement depuis un dépôt GitHub ; Hostinger fait la même chose pour quelques euros par mois, avec un nom de domaine à votre nom.
Un site statique, c'est un fichier index.html et des images, sans base de données : exactement ce qu'il faut pour un portfolio, une page d'association ou la vitrine d'un petit commerce.
La version gratuite a des limites confortables pour un étudiant : 1 Go par site et une limite souple de 100 Go de trafic par mois.
Côté marketing, c'est la première brique de toute présence en ligne, celle que les agences facturent et que vous saurez désormais évaluer.
C'est aussi le support sur lequel vous poserez plus tard un questionnaire ou un compteur de visites pour lire vos propres traces.
Le déroulé tient en quatre étapes : écrire la page, créer un compte GitHub, créer un dépôt nommé votre-pseudo.github.io, y déposer index.html et activer Pages dans les réglages du dépôt.
Vous n'avez pas à écrire le HTML vous-même : demandez-le à une IA, puis lisez-le pour reconnaître les balises vues au chapitre sur le site web.
Premier pas : ce prompt, dans Claude ou Gemini, produit une page complète à enregistrer sous le nom index.html.
promptÉcris une page web complète en un seul fichier HTML (CSS inclus dans la page, pas de JavaScript) pour le portfolio d'un étudiant en L2 Gestion à l'IAE Clermont Auvergne. Sections : présentation en trois lignes, formation, deux expériences, centres d'intérêt, contact. Style sobre, lisible sur téléphone. Remplace les informations personnelles par des crochets que je compléterai.
Une fois en ligne, modifiez une ligne, redéposez le fichier et rechargez la page : vous venez de faire une mise à jour de site, comme un webmaster.
Si vous tenez à un vrai nom de domaine, l'hébergement Hostinger fournit un gestionnaire de fichiers dans lequel on dépose le même index.html.
Gardez ce site : il servira de terrain pour les projets suivants.
Excel augmenté : analyser des données dans Google Colab
Vous avez tous un tableau quelque part : relevé de dépenses, export des ventes d'un job d'été, statistiques d'un compte Instagram.
Google Colab est un carnet Python qui tourne dans le navigateur, sans rien installer, avec un simple compte Google.
Un carnet, ou notebook Jupyter, alterne des cellules de code et des cellules de texte, et chaque cellule s'exécute avec Maj+Entrée.
Google indique que Colab est sans frais, accès à des cartes graphiques compris, avec des limites d'usage qui fluctuent dans le temps et que Google ne s'engage pas à garantir.
La bibliothèque pandas lit un fichier Excel ou CSV et le manipule comme un tableau : trier, filtrer, regrouper, calculer des moyennes.
Ce qu'Excel fait à la souris, Colab le fait en quelques lignes que l'IA écrit pour vous et qu'il suffit de coller.
Pour un marketeur, c'est l'outil pour lire les traces dont parle le chapitre « Traces digitales et marketing » : panier moyen, saisonnalité, clients qui ne reviennent pas, anomalies.
Premier pas : ouvrez un nouveau notebook, importez votre fichier par l'icône dossier du panneau de gauche, puis exécutez ces trois lignes.
pythonimport pandas as pd
df = pd.read_csv("votre_fichier.csv")   # ou pd.read_excel("votre_fichier.xlsx")
df.describe(include="all")
Copiez ensuite le résultat et les cinq premières lignes du tableau dans une IA avec ce prompt.
promptVoici la description et les premières lignes d'un tableau de données : [coller]. Quelles questions marketing ce tableau permet-il de poser ? Propose trois analyses et, pour chacune, écris le code pandas et matplotlib à exécuter dans Google Colab, avec une phrase sur ce que le graphique devrait montrer.
Collez le code dans une cellule ; si une erreur s'affiche, recopiez le message entier dans l'IA, elle corrige.
Si vous n'avez aucun tableau sous la main, data.gouv.fr en propose des milliers en accès libre, et le projet Spotify plus bas vous en fabrique un sur vos propres goûts.
Le piège classique est le graphique joli qui ne répond à aucune question : c'est le premier point que je regarde.
Une IA sur votre ordinateur (Ollama)
Jusqu'ici, chaque prompt part dans le cloud d'une entreprise américaine ; ce projet installe l'IA chez vous.
Ollama télécharge un modèle ouvert et le fait tourner sur votre machine, Windows, Mac ou Linux, après deux minutes d'installation.
Le catalogue va des petits modèles aux très gros : gemma3:4b pèse 3,3 Go et tourne sur un portable ordinaire, gemma4:e2b pèse 7,2 Go et demande davantage de mémoire vive.
Le chapitre « Les acteurs de l'IA » explique pourquoi cette voie ouverte compte ; ici, on la pratique.
Rien de ce que vous tapez ne quitte l'ordinateur : pour traiter des verbatims clients, des réclamations ou un fichier de prospects, c'est la réponse la plus simple aux exigences du RGPD rappelées par la CNIL.
Le coût par requête est nul, ce qui change le raisonnement quand on veut classer dix mille avis plutôt que dix.
Le modèle local est moins brillant que Claude ou GPT, et c'est précisément l'intérêt du projet : mesurer l'écart sur vos propres questions.
Premier pas : après l'installation, ouvrez un terminal (PowerShell sous Windows, Terminal sur Mac) et lancez ce modèle.
terminalollama run gemma3:4b
Posez-lui la question de l'activité « L'IA prise en défaut », puis la même à une IA du cloud, et notez qui se trompe.
Demandez-lui ensuite de classer des avis clients avec ce prompt.
promptVoici des avis clients, un par ligne. Pour chacun, donne le thème principal (livraison, prix, qualité, service, autre) et le sentiment (positif, neutre, négatif), sous forme de tableau. [coller cinq à dix avis]
Depuis le 23 janvier 2026, la commande ollama launch claude branche même Claude Code sur un modèle local ou sur le cloud d'Ollama, ce qui fait le pont avec le projet suivant.
Vous comprendrez au passage pourquoi le chapitre « L'avis du public » parle de mémoire vive : un modèle local, c'est d'abord de la RAM.
Déléguer à un agent (Claude Code)
Un agent ne répond pas seulement : il lit vos fichiers, planifie, écrit, exécute des commandes et corrige ses erreurs, sous votre contrôle.
Claude Code est l'agent d'Anthropic ; il s'installe en application sur Windows et Mac ou en ligne de commande selon le guide de démarrage, et c'est l'outil qui a construit ce site.
Il demande un abonnement Claude, mais l'alternative gratuite existe : ollama launch claude le fait tourner avec un modèle ouvert, et OpenCode est un agent équivalent en logiciel libre.
Le chapitre « L'enjeu du moment » défend l'idée que l'IA agentique est la révolution de 2026 ; ce projet vous la met entre les mains.
Le principe de travail : un dossier, une mission écrite, et vous regardez l'agent avancer en validant ou en refusant chacune de ses actions.
Pour un marketeur, c'est la fin des tâches répétitives : classer trois cents avis, produire le même rapport chaque lundi, renommer et redimensionner cent visuels.
C'est aussi une compétence de management : écrire une mission claire, avec un résultat vérifiable, et relire ce qui a été produit.
Premier pas : créez un dossier mes-notes avec quelques fichiers texte de vos cours, ouvrez un terminal dedans et lancez l'agent.
terminalcd mes-notes
claude
Donnez-lui cette mission.
promptLis tous les fichiers de ce dossier. Réorganise les idées par thème, puis crée un fichier fiche-revision.md avec un résumé structuré et vingt questions de QCM à quatre choix, la bonne réponse indiquée. Ne modifie pas mes fichiers d'origine.
Regardez ce qu'il demande avant d'agir : chaque autorisation que vous donnez est une décision, et c'est là que se joue la sécurité.
Relisez la fiche : un agent est rapide, pas infaillible, et une question de QCM fausse s'apprend aussi vite qu'une juste.
Quand cela fonctionne, vous êtes prêt pour le projet phare.
Le projet phare : votre Spotify local à partir d'un CSV
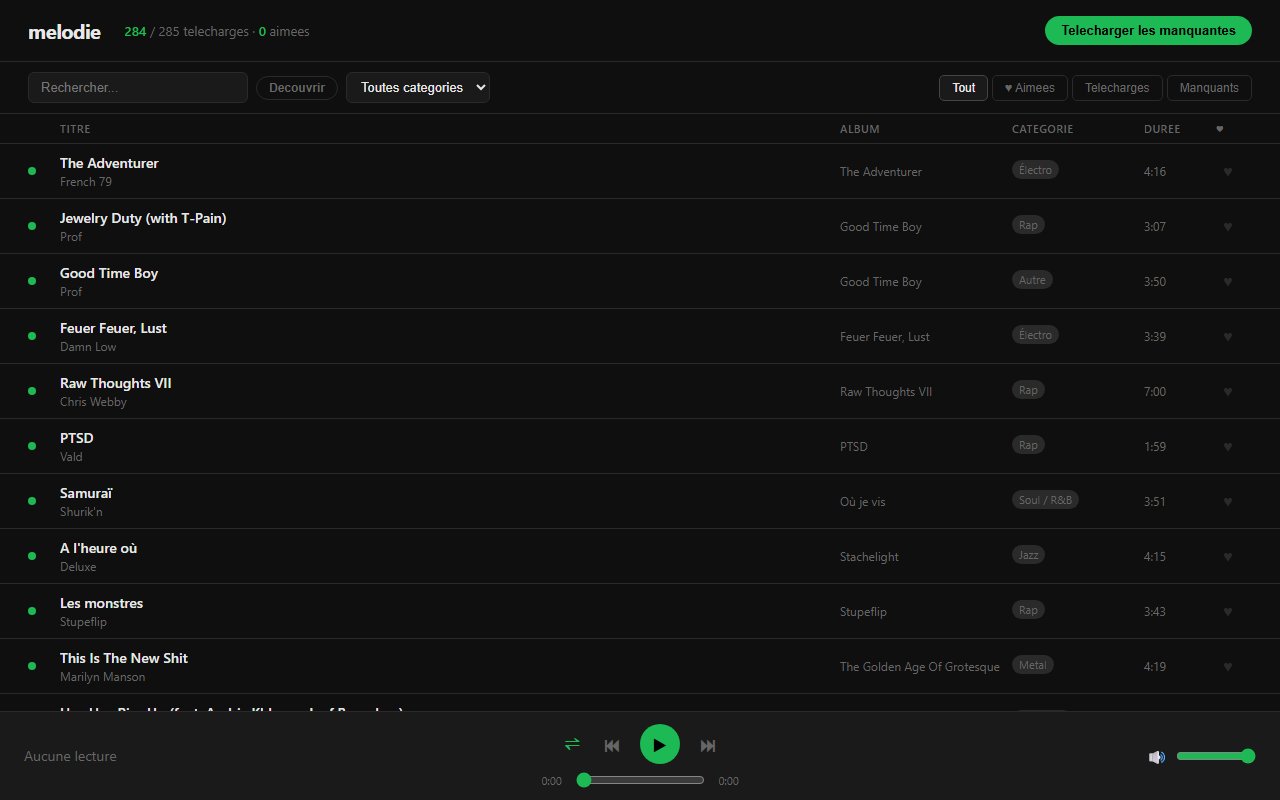
Vous l'avez vu en démonstration au chapitre « Je vous guide » : un prompt, un fichier CSV, et Claude Code reconstruit une bibliothèque musicale qui ressemble à Spotify, dans un dossier, ouverte d'un double-clic.
À vous de le refaire, avec vos propres morceaux.
Exportify est un petit service gratuit qui, une fois connecté à votre compte Spotify, exporte chaque playlist et vos titres likés en fichier CSV.
Le fichier contient une ligne par morceau et vingt-quatre colonnes : titre, artiste, album, date d'ajout, genres, popularité, et les caractéristiques audio calculées par Spotify comme la dansabilité, l'énergie, la valence et le tempo.
Ce CSV est une trace numérique au sens du chapitre « Traces digitales et marketing », sauf que cette fois c'est la vôtre, et que vous la lisez.
Spotify revendique, sur sa page de présentation consultée en septembre 2026, 777 millions d'utilisateurs, dont 300 millions d'abonnés ; son produit, c'est moins la musique que la recommandation construite sur ces colonnes.
Reconstruire une version épurée du service, c'est comprendre ce qu'il sait de vous, et ce qu'un concurrent devrait savoir faire.
Le déroulé : exporter le CSV, le placer seul dans un dossier vide, ouvrir Claude Code dans ce dossier (ou ollama launch claude), coller le prompt, attendre, double-cliquer.
Premier pas : le prompt complet.
promptDans ce dossier se trouve un export CSV de ma playlist Spotify (une ligne par morceau ; colonnes : titre, artiste, album, genres, popularité, dansabilité, énergie, valence, tempo, date d'ajout). Construis une application web locale en un seul fichier index.html, qui s'ouvre par double-clic sans serveur ni installation, et qui ressemble à un lecteur de streaming épuré : liste des morceaux avec recherche et tri, filtres par genre et par artiste, page de statistiques (répartition des genres, énergie moyenne, tempo, évolution de mes ajouts dans le temps), et un lecteur qui joue les fichiers audio que je possède déjà dans un sous-dossier music/ s'ils existent. Intègre les données du CSV directement dans la page. Cela doit fonctionner du premier coup : teste avant de me rendre la main.
« Du premier coup » n'est pas un détail : c'est ce qui sépare une démo d'un outil, et c'est ce que vous exigerez plus tard d'un prestataire.
Ma version, Mélodie, va plus loin en allant chercher l'audio en ligne ; la vôtre se contentera des morceaux que vous possédez, la question du droit d'auteur n'étant pas un détail non plus.
Ouvrez ensuite le même CSV dans Colab et demandez à quoi ressemble votre profil d'auditeur : c'est exactement le raisonnement d'un algorithme de recommandation.
Refaites enfin le projet avec un modèle local via ollama launch claude et comparez : l'écart entre un modèle ouvert et Claude se voit ici mieux que dans n'importe quel classement.
Veille économique par API (Banque mondiale)
Le chapitre « Les technologies classiques » a présenté les API ; ce projet en utilise une vraie, sans clé ni inscription.
L'API de la Banque mondiale donne accès à près de 16 000 séries d'indicateurs : PIB, chômage, inflation, population, pour tous les pays et depuis des décennies.
Une seule adresse web renvoie les chiffres au format JSON, le format des API, que pandas transforme en tableau.
Le graphique ci-dessus a été fabriqué ainsi : une requête, sept pays, les PIB de 2025 tels que publiés le 13 juillet 2026, encore révisables.
Pour un marketeur, c'est la base de toute étude de marché à l'international, et le point de départ de la séance 3 sur le marché.
L'étape suivante fait écrire la synthèse par une IA, puis vous vérifiez chaque chiffre du rapport dans le tableau, parce que c'est là que les hallucinations se glissent.
Le pipeline complet, collecte, traitement, graphique, rapport, est le travail quotidien d'un analyste, et il tient dans un seul carnet Colab.
Premier pas : dans Colab, exécutez ce code.
pythonimport requests, pandas as pd
url = "https://api.worldbank.org/v2/country/FR;DE;US;CN;JP/indicator/NY.GDP.MKTP.CD?format=json&per_page=200&date=2005:2025"
brut = requests.get(url).json()[1]
df = pd.DataFrame([{"pays": d["country"]["value"], "annee": int(d["date"]), "pib": d["value"]} for d in brut if d["value"]])
df.pivot(index="annee", columns="pays", values="pib").plot(figsize=(10, 5), title="PIB en dollars courants")
Copiez ensuite les vingt dernières lignes du tableau dans une IA avec ce prompt.
promptTu es analyste. Voici le PIB de cinq pays sur vingt ans, en dollars courants : [coller]. Rédige une note de veille en quatre parties : tendances, comparaison, signaux faibles, recommandations pour une entreprise française qui hésite entre ces marchés. Chaque affirmation doit citer un chiffre du tableau.
Vérifiez trois chiffres au hasard : si l'un est faux, vous tenez un cas d'école à me montrer en séance.
Pour aller plus loin, croisez avec les données françaises de l'INSEE, et imaginez le même carnet qui tourne tout seul chaque lundi matin.
Vision par ordinateur : compter les voitures de Bison Futé

Le projet le plus ambitieux : faire compter des véhicules à une IA sur les images des caméras routières publiques.
La vision par ordinateur apprend à une machine à reconnaître ce qu'il y a dans une image ; le modèle YOLO le fait en une seule passe, assez vite pour traiter de la vidéo.
Bison Futé, le service d'information routière de l'État, affiche des caméras en direct sur ses cartes, y compris autour de Clermont-Ferrand.
Colab prête une carte graphique, de façon limitée en version sans frais, la bibliothèque Ultralytics fournit YOLO prêt à l'emploi, et l'IA écrit le code de bout en bout.
Vous n'écrirez pas une ligne vous-même, mais vous devrez comprendre ce que le modèle voit et ce qu'il rate : voitures masquées, nuit, pluie, camions comptés deux fois.
Pour un marketeur, compter, c'est mesurer une fréquentation : les passages devant une vitrine, l'affluence d'un rayon, le remplissage d'un parking, autant de traces physiques évoquées au chapitre « Traces digitales et marketing ».
La grande distribution le fait déjà, et la CNIL encadre ces caméras dites augmentées, par exemple aux caisses automatiques.
Premier pas : dans Colab, activez la carte graphique (menu Exécution, Modifier le type d'exécution, GPU T4), puis récupérez l'adresse d'une image de caméra sur la carte Bison Futé par clic droit, « Copier l'adresse de l'image ».
Demandez ensuite le code avec ce prompt.
promptÉcris le code d'un notebook Google Colab qui installe ultralytics, télécharge l'image à cette adresse : [URL de l'image], applique le modèle YOLO le plus léger pour détecter les véhicules (voitures, camions, bus, motos), affiche l'image annotée et imprime le nombre de véhicules par catégorie. Explique chaque cellule en une phrase.
Exécutez, corrigez avec l'IA si besoin, puis relancez sur la même caméra à trois moments de la journée.
La question finale n'est pas technique : à partir de quel taux d'erreur ce comptage cesse-t-il d'être une information utile pour décider ?
Choisissez, testez, changez, questionnez
| Projet | Outil | Coût | Niveau | Ce que vous comprenez |
|---|---|---|---|---|
| Visuel puis vidéo | Gemini, Google Flow | Gratuit pour l'image, crédits pour la vidéo (offre étudiante jusqu'au 31 décembre 2026) | Débutant | Le prompt, la création de contenu |
| Premier site web | GitHub Pages, Hostinger | Gratuit, ou quelques euros par mois | Débutant | Comment vit un site |
| Excel augmenté | Google Colab | Gratuit | Intermédiaire | Lire des données avec du code |
| IA locale | Ollama | Gratuit | Intermédiaire | Modèle ouvert, confidentialité |
| Agent | Claude Code, OpenCode | Abonnement, ou gratuit via Ollama | Avancé | Déléguer et superviser |
| Spotify local (projet phare) | Exportify, Claude Code | Abonnement, ou gratuit via Ollama | Avancé | Données, recommandation, produit |
| Veille par API | Banque mondiale, Colab | Gratuit | Avancé | API, pipeline, vérification |
| Vision par ordinateur | Colab, Ultralytics, Bison Futé | Gratuit | Expert | Mesurer le réel, et ses limites |
Vous avez huit projets, classés du plus accessible au plus exigeant, et le tableau ci-dessus les résume.
Pour le reste du cours, la consigne est simple : vous choisissez un projet, vous le testez, vous l'approfondissez, puis vous passez à un autre.
Il n'y a ni rendu ni note sur ces projets : la seule évaluation du module reste le QCM de fin de semestre.
L'objectif est ailleurs : que chacun ait, en décembre, fait tourner une IA autrement qu'en lui posant des questions.
Le bon ordre est le vôtre : un étudiant à l'aise avec l'informatique peut commencer par l'agent, un autre par le visuel de marque.
Quand ça bloque, copiez le message d'erreur entier dans l'IA avant de chercher ailleurs : c'est le premier réflexe.
Quand ça marche, changez un paramètre pour voir ce qui casse : c'est le second.
Les plus motivés pourront me montrer ce qu'ils ont construit ; ce n'est pas noté, c'est mieux que ça.
Et venez me poser des questions, pendant la séance ou à la fin, je suis là pour ça.